Tabla de contenidos
- ¿Qué son los paneles de acceso legado?
- ¿Por qué los paneles de acceso heredados están fallando en 2026?
- Cómo detectar y eliminar la fraude en encuestas: un enfoque sistemático
- Siete métricas conductuales que revelan de forma inmediata a los encuestados fraudulentos
- Metodologías alternativas: avanzando más allá de los paneles comprometidos
- Cómo la IA transformará la detección de fraude en encuestas en 2026
- Herramientas y recursos esenciales para la integridad de los datos de encuestas
- Protegiendo las inversiones en investigación empresarial contra el fraude
- Preguntas frecuentes
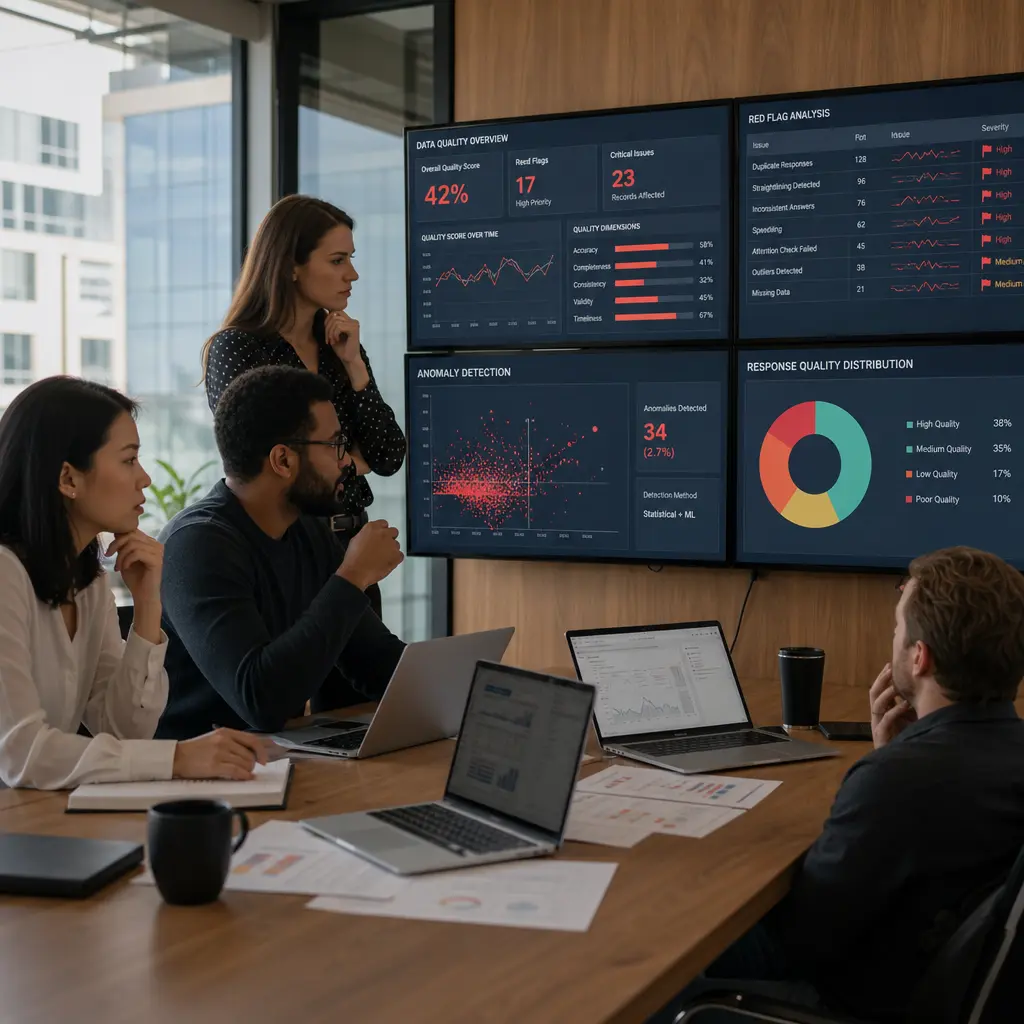
Entre el 15% y el 40% de las respuestas en los paneles de acceso tradicionales provienen de fuentes fraudulentas: bots, click farms y sistemas de incentivos para encuestadores profesionales. Para las empresas que invierten seis o siete cifras en investigación de mercado cada año, esta contaminación convierte las ideas estratégicas en una ficción costosa. Un estudio de precios adulterado por 30% encuestados fraudulentos no solo malgasta el presupuesto de investigación; también envenena los modelos de ingresos, los planes de productos y las decisiones de entrada al mercado durante años.
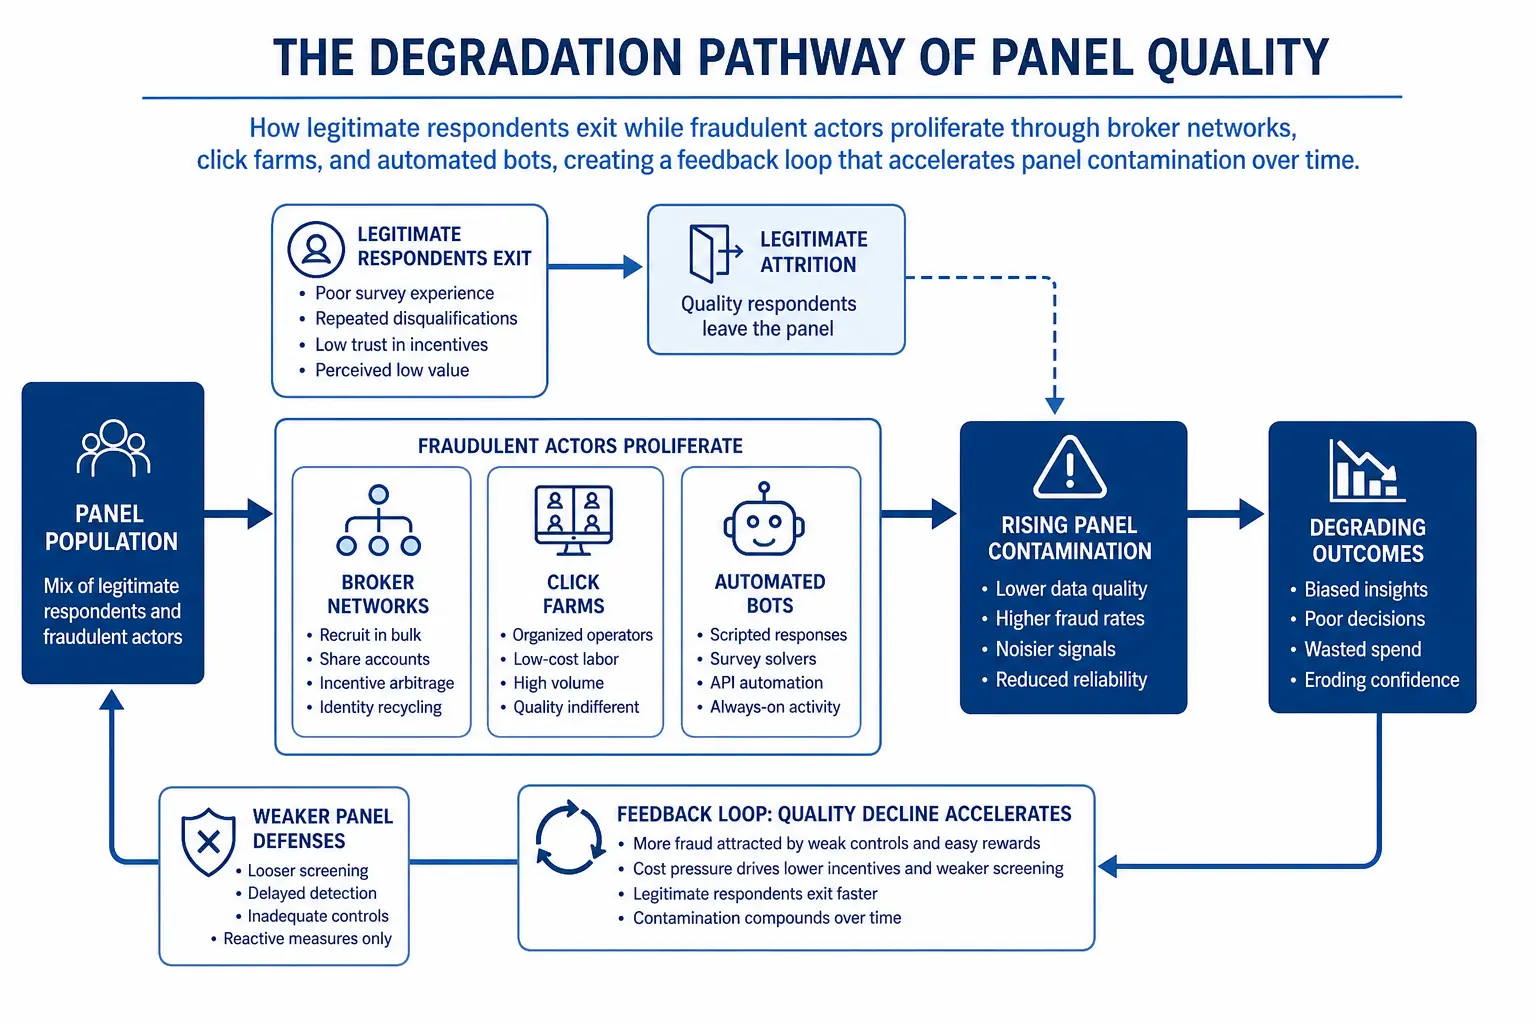
La infraestructura que ha dado soporte a la investigación de mercado durante dos décadas está colapsando. Paneles de acceso legado Las bases de datos preseleccionadas de los encuestados enfrentan una crisis existencial, ya que la calidad se deteriora más rápidamente de lo que los proveedores pueden reconstruir la confianza. Los encuestados legítimos abandonan los paneles sobrecargados de trabajo, mientras que los actores fraudulentos se multiplican a través de redes de intermediarios que priorizan el volumen sobre la verificación. Los equipos de análisis han trabajado en el sector de la salud, la tecnología y los servicios financieros para identificar y eliminar datos fraudulentos de encuestas que ya habían influido en decisiones multimillonarias.
La amenaza va más allá de los simples bots. Los grandes modelos de lenguaje ahora generan respuestas abiertas contextualmente apropiadas. Las empresas de encuestas emplean humanos para eludir la detección tradicional de fraudes. Los corredores de panel venden los mismos encuestados a docenas de proveedores competidores, creando así a encuestadores profesionales que aprenden a burlar los filtros de calificación y los controles de atención.
En esta guía descubrirás por qué los paneles de acceso heredados están fallando, cómo detectar y eliminar encuestados fraudulentos, qué métricas de comportamiento revelan fraudes sofisticados y qué metodologías alternativas protegerán la integridad de la investigación empresarial en 2026.
¿Qué son los paneles de acceso legado?
Los paneles de acceso legado son bases de datos preseleccionadas de encuestados que se han registrado para participar en estudios de investigación de mercado a cambio de incentivos, gestionados normalmente por proveedores externos que venden acceso a investigadores que apuntan a segmentos demográficos o profesionales específicos. Estos paneles surgieron a finales de la década de 1990 cuando la investigación en línea reemplazó a las encuestas telefónicas y por correo, ofreciendo a los investigadores un acceso rápido a audiencias específicas sin los requisitos de tiempo y costos asociados a la recolección de nuevas muestras para cada estudio.
El modelo tradicional de paneles funciona mediante anuncios de reclutamiento que llevan a los registrante a completar encuestas de perfil detalladas que abordan datos demográficos, comportamientos de compra, cualificaciones profesionales e intereses de la categoría. Los proveedores mantienen estos perfiles en bases de datos propias, luego combinan los proyectos de investigación recibidos con panelistas calificados basándose en criterios de segmentación. Los panelistas reciben invitaciones por correo electrónico para encuestas que coinciden con sus perfiles, ganando puntos, dinero en efectivo o tarjetas de regalo por las respuestas completadas.
Durante quince años, este modelo dominó la investigación de mercado en línea. Los paneles ofrecían un acceso económico a audiencias difíciles de alcanzar: profesionales de la salud, ejecutivos de alto nivel y pacientes con enfermedades raras que sería prohibitivamente costoso reclutar a través de otros canales. Los principales compradores de investigación construyeron metodologías completas en torno a las capacidades de los paneles, desde el seguimiento de estudios realizados trimestralmente hasta la misma recopilación de datos de los mismos participantes, pasando por análisis conjuntos complejos que requirían cientos de participantes cualificados.
Las economías que hicieron atractivos los paneles también crearon las condiciones para su colapso. A medida que aumentaba el uso de estos, los encuestados legítimos empezaron a sentir la fatiga por el volumen excesivo de invitaciones. Simultáneamente, la estructura de incentivos atraía a actores fraudulentos que reconocían que completar encuestas generaba ingresos confiables con una supervisión mínima. Surgieron los panel brokers para arbitrar la oferta y la demanda, reclutando a los panelistas una vez y luego vendiéndoles el acceso a decenas de proveedores competidores. Esta práctica inflaba los tamaños aparentes de los paneles al tiempo que degradaba la calidad debido a la duplicación y la realización de demasiados encuestados.
¿Por qué los paneles de acceso heredados están fallando en 2026?
La crisis de la calidad de los paneles alcanzó su punto crítico en el período 2024-2026, cuando varios vectores de degradación se agruparon. Análisis de la industria para 2024 Se documentan tasas de fraude entre el 25 y el 45% en los principales paneles B2B, y algunos paneles de profesionales de la salud muestran niveles de contaminación superiores al 60%. Estos números representan un punto de inflexión en el que la calidad de los datos de los paneles se queda por debajo del umbral requerido para tomar decisiones empresariales confiables.
Los encuestadores profesionales ahora constituyen la mayoría de los encuestados activos en muchos paneles. Estas personas participan semanalmente en docenas de encuestas, aprendiendo a reconocer y eludir los controles de calidad, memorizando respuestas consistentes a preguntas de perfil en múltiples participaciones en paneles y optimizando la velocidad de respuesta para maximizar los ingresos por hora. Sus respuestas reflejan una experiencia en la realización de encuestas, en lugar de un conocimiento genuino de las categorías o actitudes auténticas.
La sofisticación de los bots ha ido más allá de la simple automatización de la cumplimentación de formularios. Los bots de encuestas modernos utilizan visión por computadora para resolver CAPTCHA, alaranjar el tiempo de respuesta para simular la variabilidad del comportamiento humano y aprovechar cada vez más modelos de lenguaje de gran tamaño para generar respuestas abiertas y contextualmente apropiadas que superan los controles básicos de coherencia. Una red de bots puede completar miles de encuestas al día, compartiendo los incentivos con los paneles de encuestados que comprometen o con los intermediarios que proporcionan el acceso.
Las farmacias Click agregan una capa humana a la fraude que supera muchos sistemas automatizados de detección. Operando principalmente en regiones con bajos costos laborales, los trabajadores de las farmacias Click completan las encuestas manualmente utilizando VPNs y el spoofing de dispositivos para parecerse a respondientes legítimos de geografías objetivo. Siguen scripts para mantener la consistencia de las respuestas y emplean bases de conocimientos compartidas que documentan cómo calificar para estudios de alto valor. Dado que los encuestados son humanos reales, eligen eludir los sistemas de detección de comportamiento diseñados para detectar bots.
Las redes de intermediarios de paneles amplifican estos problemas al ocultar la identidad de los encuestados entre los diferentes proveedores. Una misma persona podría tener cuentas en seis diferentes intermediarios, cada uno de los cuales le proporciona acceso a múltiples proveedores de paneles, creando la ilusión de que los encuestados son únicos cuando los investigadores compran de diferentes fuentes. Este duplicado supone que las empresas pagan por una diversidad de muestras que nunca reciben, y los mismos encuestados fraudulentos o profesionales contaminan los estudios de distintas fuentes que supuestamente son independientes.
Los incentivos económicos que impulsan la degradación de los paneles no muestran signos de revertirse. A medida que los encuestados que valoran la calidad abandonan paneles sobrecargados de encuestas, los proveedores se enfrentan a la presión de mantener los tamaños de panel y la velocidad de cumplimiento declarados. Esta presión incentiva estándares de verificación más laxos, la aceptación de encuestados procedentes de intermediarios y la tolerancia a problemas de calidad que habrían llevado a la cancelación de cuentas en épocas anteriores de los paneles. El resultado es una espiral descendente en la que la disminución de la calidad acelera la pérdida de encuestados legítimos, lo que aumenta aún más la dependencia de fuentes fraudulentas.
Cómo detectar y eliminar la fraude en encuestas: un enfoque sistemático
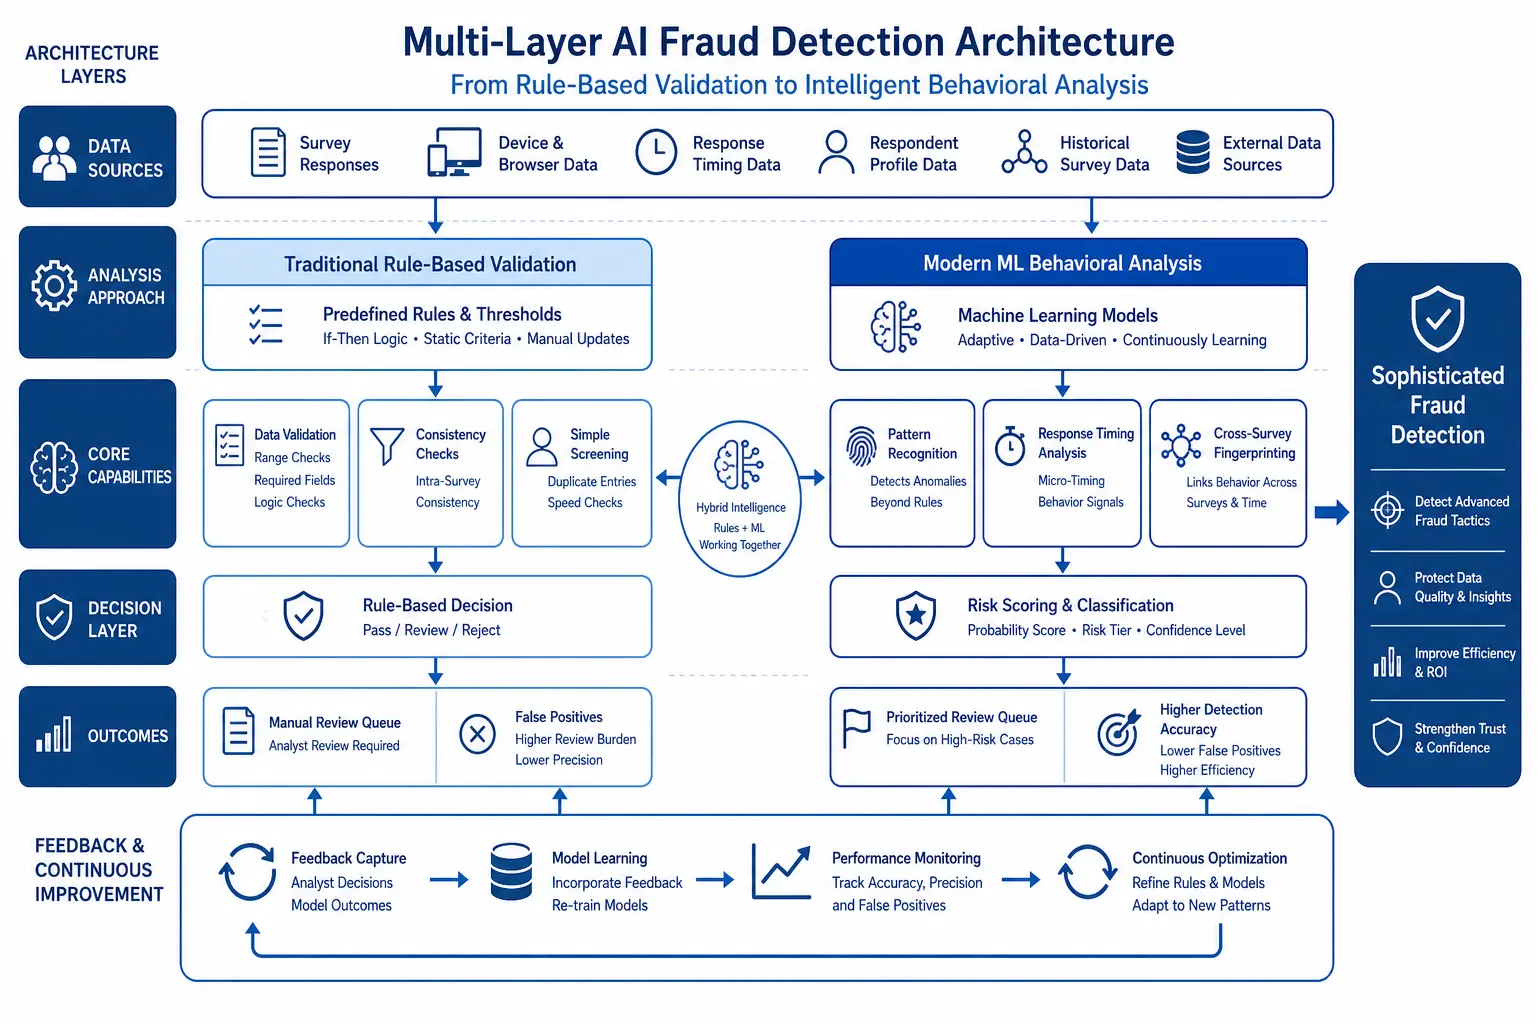
La protección de la integridad de la investigación requiere una detección de fraudes en múltiples etapas, desde la obtención de muestras hasta la entrega de datos. Ninguna verificación individual detecta todos los tipos de fraude; los estafadores sofisticados diseñan sus métodos específicamente para eludir los métodos de detección comunes. La siguiente estrategia sistemática combina la obtención preventiva de datos, el monitoreo en tiempo real y el análisis forense posterior a la recopilación.
Paso 1: Implementar la verificación a nivel de origen antes del lanzamiento de la encuesta. Las capacidades de detección de fraude de los paneles de auditoría se basan en solicitudes de documentación técnica, no en afirmaciones de marketing. Exigen que los proveedores documenten sus sistemas de detección de bots, métodos de digitalización de dispositivos, procesos de validación de IP y deduplicación de respondientes en sus redes de intermediarios. Los proveedores que no puedan o no quieran proporcionar detalles técnicos probablemente carezcan de una robusta prevención de fraudes. Soliciten información sobre la tasa de fraude de estudios similares realizados en los últimos seis meses y establezcan sanciones contractuales en caso de que las tasas de fraude superen los umbrales acordados.
Pas 2: Implementar el monitoreo de comportamiento en tiempo real de múltiples capas. Investigaciones instrumentales con seguimiento de comportamiento que captan el tiempo de respuesta a nivel de preguntas, patrones de movimiento del ratón, datos de sensores del dispositivo y secuencias de interacción. Identificar a los encuestados que completan preguntas complejas en tiempos estadísticamente improbables, que los humanos no pueden leer y responder de forma ponderada a una cuadrícula de 10 preguntas en ocho segundos, pero que los bots lo hacen rutinariamente. Vigilar por cualquier uniformidad inusual en los patrones de tiempo; los humanos muestran variaciones naturales en la velocidad de lectura y respuesta, mientras que los bots y los trabajadores de click farms que siguen guiones muestran un ritmo de respuesta consistentemente constante.
Pas 3: Incorpore controles sofisticados de atención y lógica. Pasar de simples comprobaciones de atención que solo indican la opción C, que los estafadores reconocen y pasan fácilmente. Implementar trampas lógicas que requieran comprensión contextual en múltiples preguntas, por ejemplo, preguntar sobre la satisfacción con una característica del producto y luego preguntar sobre la frecuencia de uso de esa misma característica, destacando a los encuestados que afirman una alta satisfacción pero que nunca la utilizan. Incluir preguntas abiertas que requieran conocimientos específicos de cada categoría, algo que los sistemas de inteligencia artificial tienen dificultades para imitar de manera convincente, como descripciones detalladas de procesos o el uso de terminología técnica.
Paso 4: Referencia cruzada de las huellas dactilares digitales y los datos de geolocalización. Recopila las huellas dactilares del dispositivo combinando la configuración del navegador, la resolución de la pantalla, las fuentes instaladas y los identificadores de hardware para detectar a los encuestados que utilizan el spoofing de dispositivos o completan encuestas desde centros de datos en lugar de conexiones residenciales. Verifique la geolocalización IP en comparación con los datos demográficos declarados: un encuestado que afirma vivir en Chicago pero que se conecta desde una dirección IP vietnamita requiere una investigación. Marque como sospechoso a los encuestados que utilicen VPN o servicios proxy, algo que los encuestados legítimos rara vez emplean pero que los estafadores utilizan rutinariamente.
Paso 5: Analice los patrones de respuesta para detectar anomalías estadísticas. Aplicar el control estadístico de procesos para identificar a los encuestados cuyos patrones de respuesta se desvían de las distribuciones esperadas. La repetición de respuestas idénticas, los patrones diagonales en las preguntas de cuadrícula y el uso excesivo de puntos medios neutros indican una baja participación o una respuesta fraudulenta. Compare las distribuciones de respuestas individuales con el conjunto; los encuestados fraudulentos suelen presentar patrones de respuesta que son estadísticamente improbables cuando se examinan en el contexto de la muestra más amplia.
Pas 6: Realice un análisis de participación en encuestas cruzadas. En el caso de las muestras de paneles, solicite el historial de participación de los encuestados en todas las encuestas realizadas con ese proveedor en los últimos 90 días. Marque como activas las personas que completan más de 15 a 20 encuestas al mes: este volumen indica que se trata de encuestas realizadas por profesionales, y no de participación ocasional. Compare los identificadores de los encuestados con las bases de datos de fraude conocidas mantenidas por consorcios industriales; los estafadores sofisticados reutilizan credenciales comprometidas en múltiples plataformas.
Paso 7: Realice la auditoría forense de los datos tras la recopilación. Tras la recopilación de datos, llevar a cabo auditorías sistemáticas de calidad que examinen simultáneamente múltiples indicadores de fraude. Calcular puntuaciones de calidad combinando el tiempo de respuesta, el rendimiento del control de atención, la calidad de las respuestas abiertas y la consistencia de comportamiento. Establecer umbrales de eliminación basados en puntuaciones de calidad acumuladas en lugar de fallos individuales en una sola métrica. Este enfoque detecta a estafadores sofisticados que superan los controles individuales pero presentan patrones sospechosos en múltiples dimensiones. Documentar todos los eliminaciones con justificativas específicas para respaldar las afirmaciones sobre la integridad de los datos.
Pas 8: Validar los resultados en función de parámetros externos. Compare los principales resultados con datos de seguimiento de entidades externas, estadísticas gubernamentales u otras fuentes independientes para identificar resultados que difieran de manera sospechosa de los parámetros establecidos. Los datos fraudulentos suelen presentar una varianza más reducida y respuestas más extremas debido a que los estafadores evitan responder a preguntas que podrían llamar la atención o parecer “equivocadas”. Si su encuesta muestra una sensibilización del producto o un compromiso con la categoría de forma inaceptable en comparación con los parámetros verificados, la contaminación fraudulenta probablemente explique la discrepancia.
Siete métricas conductuales que revelan de forma inmediata a los encuestados fraudulentos
1. Coeficiente de variación del tiempo de respuesta. Calcule el coeficiente de variación (desviación estándar dividida por el promedio) para los tiempos de respuesta en todas las preguntas. Los respondientes legítimos muestran coeficientes de variación entre 0,4 y 0,8 a medida que responden a preguntas fáciles y más bajos para las complejas. Los respondientes fraudulentos, especialmente los bots y los trabajadores de click farms que siguen guiones preprogramados, muestran coeficientes de variación por debajo de 0,3. Su tiempo es inusualmente constante porque en realidad no están leyendo ni pensando.
2. Puntuación de la entropía de la huella dactilar del dispositivo. Las configuraciones comunes de navegadores con huellas dactilares de dispositivos, las fuentes predeterminadas y las resoluciones de pantalla genéricas indican máquinas virtuales o herramientas de spoofing de dispositivos que los estafadores utilizan para generar dispositivos falsos. Los dispositivos legítimos de consumo presentan una huella dactilar alta con configuraciones personalizadas, aplicaciones instaladas y combinaciones de hardware únicas que son casi imposibles de replicar artificialmente.
3. Complexidad lingüística de las respuestas abiertas. Analice las respuestas abiertas en busca de diversidad léxica, variaciones en la estructura de las oraciones y uso de terminología específica del campo. Las respuestas generadas por el LLM suelen mostrar una perfección gramatical inusual combinada con un lenguaje general que carece de la autenticidad y los errores ocasionales propios de la escritura humana. Las respuestas que parecen ser una copia de marketing en lugar de una explicación conversacional merecen un análisis más detenido.
4. Detección de patrones diagonales en cuadrícula. En las preguntas en matrices o cuadrículas, calcule la correlación entre la posición de respuesta y la selección de opción. Los encuestados fraudulentos suelen seleccionar respuestas de forma diagonal o geométrica (seleccionando la opción 1 para la fila 1, la opción 2 para la fila 2, etc.), porque este enfoque minimiza la carga cognitiva. Los encuestados legítimos no muestran ninguna correlación entre la posición de la fila y la selección de respuesta.
5. Análisis de la reputación de la dirección IP y del proveedor de alojamiento web. Realice una comparación cruzada entre los direcciones IP de los encuestados y las bases de datos de centros de datos conocidos, nodos de salida de VPN y servicios de proxy. Los encuestados legítimos se conectan desde ISP residenciales; los encuestados fraudulentos se conectan desproporcionadamente desde proveedores de alojamiento, servicios en la nube y VPN comerciales. Una dirección IP previamente asociada con spam, fraude o actividad de bots en otras plataformas predice con gran fiabilidad la fraude en encuestas.
6. Velocidad de participación en encuestas cruzadas. Para los encuestados en grupos de panel, calcule la cantidad de encuestas completadas al día durante los últimos 30 días. Los panelistas ocasionales legítimos realizan en promedio 2-4 encuestas al mes. Los encuestadores profesionales realizan 3-5 encuestas al día, lo que genera velocidades de participación 10-20 veces superiores a las de los encuestados auténticos. Cualquier persona que complete más de dos encuestas en un solo día debería ser objeto de una validación adicional.
7. Entropía de respuesta en preguntas escaladas. Calcule la entropía de Shannon para las respuestas dentro de las baterías escaladas, que miden el grado de variación en las selecciones de respuesta. Los respondientes fraudulentos presentan una entropía más baja porque utilizan estrategias de satisfacción como seleccionar siempre el punto medio o alternar entre dos opciones adyacentes. Los respondientes comprometidos legítimos presentan una entropía más alta, ya que discriminan entre los ítems en función de actitudes genuinas.
Metodologías alternativas: avanzando más allá de los paneles comprometidos
A medida que la calidad del panel de acceso heredado se deteriora hasta el punto de ser irreparable para muchos casos de uso, las empresas están adoptando metodologías alternativas de muestreo que reducen la exposición a fraudes y permiten obtener respuestas de mayor calidad.
La toma de muestras de ríos permite obtener datos de los visitantes del tráfico web en vivo a través de asociaciones con editoriales y redes de publicidad programática. En lugar de reclutar panelistas que se incorporen a una base de datos y reciban invitaciones a encuestas, el muestreo de ríos captura a los usuarios durante las sesiones de navegación natural en sitios de contenido, plataformas sociales y aplicaciones móviles. Este enfoque elimina la contaminación de los encuestadores profesionales, ya que los encuestados nunca se incorporan a un panel ni adquieren experiencia en la realización de encuestas. Los muestreos de ríos brindan acceso a audiencias más difíciles de alcanzar que nunca se inscribirían en un panel, pero completarán una única encuesta cuando se encuentren en un contexto adecuado.
La contratación a través de plataformas de medios sociales mediante APIs de publicidad permite una segmentación precisa manteniendo la autenticidad de los encuestados. Los investigadores pueden dirigir los anuncios a segmentos demográficos, de comportamiento e intereses específicos, lo que permite que los encuestados calificados respondan a las encuestas sin intermediarios de paneles. Este método funciona especialmente bien para categorías de consumidores donde los datos de las plataformas sociales proporcionan señales de segmentación muy valiosas. El desafío radica en gestionar el coste por encuesta completo, que suele superar el precio de los paneles pero ofrece una calidad de datos sustancialmente superior.
La muestra de la base de datos de clientes aprovecha datos propios que ya poseen las empresas. Para la satisfacción del cliente, la retroalimentación sobre productos y la investigación de fidelidad, la muestra de las bases de datos de CRM elimina por completo el riesgo de fraude. Usted está encuestando a clientes verificados con historial de transacciones. Este enfoque requiere un diseño cuidadoso de la muestra para evitar encuestas excesivas en clientes valiosos, pero proporciona la mayor confianza en la autenticidad y relevancia de los encuestados.
Las metodologías híbridas combinan múltiples fuentes para equilibrar costos, velocidad y calidad. Una aproximación híbrida típica podría utilizar muestreo de bases de datos de clientes para los clientes actuales, muestreo de ríos para los usuarios de marcas competitivas y fuentes de paneles cuidadosamente seleccionados para audiencias de bajo índice de participación que son prohibitivamente costosas de alcanzar a través de otros canales. La clave está en reconocer que ninguna fuente individual optimiza simultáneamente todas las dimensiones; la mezcla estratégica de fuentes basada en objetivos de investigación produce resultados mejores que optar por paneles para todos los estudios.
Cómo la IA transformará la detección de fraude en encuestas en 2026
La inteligencia artificial se ha convertido en la principal herramienta en la carrera armamentista por la detección de fraudes, permitiendo el reconocimiento de patrones a escalas y velocidades imposibles para los analistas humanos. Los modelos de aprendizaje automático entrenados con millones de respuestas a encuestas pueden identificar señales conductuales sutiles que distinguen el compromiso auténtico del completamiento fraudulento.
El análisis biométrico conductual aplica la visión computacional y la fusión de sensores para detectar la realización de encuestas por parte de personas no humanas. Estos sistemas analizan las trayectorias de movimiento del ratón, los patrones de presión al hacer clic, el comportamiento de desplazamiento y los cambios de orientación del dispositivo para crear perfiles conductuales. Los humanos muestran microcorrecciones naturales, trayectorias curvas del ratón y velocidades de interacción variables; los bots muestran líneas perfectamente rectas, cambios de dirección instantáneos y una consistencia mecánica. Sistemas avanzados pueden identificar a los trabajadores de las plantillas de clic al detectar múltiples respondientes que comparten patrones conductuales idénticos, una señal de seguir un script que los analistas humanos pasarían por alto.
Los modelos de procesamiento de lenguaje natural evalúan las respuestas abiertas en busca de marcadores de autenticidad que distinguen la escritura humana de la generación por parte de la IA. Si bien las respuestas generadas por la IA en etapas tempranas eran fáciles de detectar debido a un lenguaje excesivamente formal y a frases genéricas, los modelos de lenguaje de la era 2026 producen textos más convincentes. Los sistemas de detección ahora analizan la coherencia semántica en múltiples preguntas abiertas, buscando inconsistencias que revelen la utilización de copiado y pegado o de plantillas, y examinan las huellas lingüísticas como la diversidad del vocabulario y la complejidad sintáctica que diferencian la escritura humana de la IA.
La resolución de identidades en múltiples plataformas vincula el comportamiento de los encuestados en encuestas, paneles y propiedades digitales para crear perfiles de fraude completos. Estos sistemas utilizan un método de coincidencia probabilística que combina huellas digitales de dispositivos, patrones de comportamiento y consistencia demográfica para identificar cuando el mismo individuo o bot opera múltiples cuentas. Esta capacidad resulta particularmente valiosa para detectar fraudes de los intermediarios de paneles, donde el mismo encuestado aparece como individuos aparentemente únicos en diferentes fuentes de proveedores.
La puntuación predictiva de fraudes asigna probabilidades de calidad en tiempo real a cada respondiente a medida que este avanza a través de una encuesta, lo que permite una intervención dinámica. En lugar de esperar el análisis posterior a la recopilación de datos, estos sistemas alertan sobre los respondientes sospechosos durante el proceso de completación, bien terminando el proceso de manera inmediata o redirigiendo al respondiente a preguntas de validación adicionales. Este enfoque reduce la recopilación de datos de fraude y permite a los investigadores reemplazar los respondientes señalados en tiempo real, manteniendo los tamaños de muestra objetivo sin comprometer la calidad.
Una buena estrategia para detectar fraudes en encuestas debería integrar múltiples sistemas de inteligencia artificial en un marco de garantía de calidad unificado que se adapte a las tácticas fraudulentas en evolución. Al combinar biometría comportamental, análisis de NLP, resolución de identidades en múltiples plataformas y puntuación predictiva, esta metodología debería tener como objetivo alcanzar tasas de detección de fraudes superiores al 95% manteniendo tasas de falsos positivos por debajo del umbral del 2%, el cual no permite la eliminación inadvertida de los encuestados legítimos por parte de la aplicación de la normativa de calidad.
Herramientas y recursos esenciales para la integridad de los datos de encuestas
Identidad relevante proporciona la fingerprinting de dispositivos y la verificación de identidad digital diseñados específicamente para aplicaciones de investigación de mercado. Su plataforma analiza más de 50 señales de dispositivos y comportamiento para detectar respondentes duplicados, tráfico de bots y uso de VPN, integrándose directamente con las principales plataformas de encuestas para alertar en tiempo real sobre respondentes sospechosos.
Imperium Ofrece una suite integral de detección de fraudes que combina análisis de comportamiento, puntuación de reputación IP y seguimiento de participación en encuestas cruzadas. Su solución RelevantID se ha convertido en un estándar industrial para verificar la calidad de los paneles, proporcionando puntajes de fraude que los investigadores pueden utilizar para filtrar muestras antes del análisis. La plataforma mantiene una base de datos global de fraudes que permite detectar patrones cruzados entre clientes.
Detención de Fraude de Qualtrics Incorpora controles de calidad directamente en la plataforma de encuestas, incluyendo detección de bots, verificaciones de atención y análisis de patrones de respuesta. Sus modelos de aprendizaje automático señalan automáticamente a los respondientes sospechosos basándose en tiempos, consistencia y anomalías de comportamiento, con umbrales configurables que los investigadores pueden ajustar en función de los requisitos del estudio y la tolerancia al riesgo.
Lucid Quality Assurance proporciona una prevención de fraudes en múltiples capas para muestras procedentes de mercados, incluyendo la obtención de huellas digitales digitales antes de la encuesta, el monitoreo de comportamiento en tiempo real y el análisis forense posterior a la recolección. Su métrica de Calidad de Producto combina múltiples indicadores de fraude en una única evaluación de calidad a nivel de los encuestados, que los investigadores pueden utilizar para tomar decisiones de limpieza de datos.
FraudScore Se especializa en análisis de reputación IP y verificación de geolocalización, comparando los datos de conexión de los encuestados con bases de datos de centros de datos conocidos, servicios VPN y redes proxy. Esta herramienta es particularmente valiosa en investigaciones internacionales donde la verificación geográfica es crucial para la validez de la muestra.
OpenText Magellan aplica análisis avanzado de texto y NLP para evaluar la calidad de las respuestas abiertas, detectando comportamientos de copiado y pasteo, uso de plantillas y contenido generado por LLM. La plataforma puede procesar miles de respuestas en segundos, alertando sobre patrones de texto sospechosos que llevarían horas a los analistas humanos para identificarlos.
Protegiendo las inversiones en investigación empresarial contra el fraude
El colapso de los paneles de acceso heredados representa tanto una crisis como una oportunidad para la investigación de mercado empresarial. Las organizaciones que sigan recurriendo a fuentes de paneles comprometidas tomarán decisiones cada vez más costosas basadas en datos fraudulentos. Aquellas que adapten sus metodologías, implementen una detección rigurosa de fraudes y diversifiquen las fuentes de muestra obtendrán una ventaja competitiva gracias a insights de mayor calidad.
El camino a seguir requiere reconocer que el modelo de paneles que funcionó bien para la investigación durante quince años ha fallado fundamentalmente. Las tasas de fraude en muchos paneles heredados ahora superan los niveles en los que los datos siguen siendo utilizables para la toma de decisiones estratégicas. La fraude en encuestas no es un problema de control de calidad que se pueda resolver con controles más estrictos; es un problema estructural que requiere una transformación metodológica. Las empresas deben reconstruir sus programas de investigación a partir de enfoques de muestreo resistentes a la fraude, desde la toma de muestras en ríos y la contratación social hasta la toma de muestras en bases de datos de clientes y metodologías híbridas.
La tecnología proporciona herramientas poderosas para detectar y eliminar respuestas fraudulentas, pero la tecnología por sí sola no puede compensar las fuentes de muestras fundamentalmente comprometidas. La detección de fraudes impulsada por IA, la biometría comportamental y la resolución de identidades en múltiples plataformas mejoran drásticamente la calidad de los datos cuando se aplican a muestras con tasas de fraude manejables. Estas mismas herramientas no pueden rescatar datos de paneles en los que la fraude supera el 40-50% de respuestas en ese nivel de contaminación; además, la muestra original no se puede salvar independientemente de la limpieza posterior a la recolección.
Las implicaciones financieras exigen acción. La fraude en encuestas cuesta a las empresas miles de millones de dólares cada año en gastos directos de investigación y en oportunidades perdidas debido a decisiones estratégicas erróneas. Un único estudio de precios contaminado puede dañar los modelos de ingresos durante años. Una análisis fraudulento de dimensionamiento del mercado puede justificar inversiones en entrada al mercado que nunca fueron viables. El costo de implementar una detección rigurosa de fraudes y diversificar las fuentes de datos es insignificante en comparación con el costo de decisiones basadas en datos fraudulentos.
Explora cómo H-in-Q.com puede ayudarte Su organización implementa sistemas de detección de fraudes impulsados por IA y pasa a utilizar metodologías de investigación resistentes a la fraude, lo que protege sus insights estratégicos de la contaminación. Las empresas que actúen ahora para abordar la crisis de la calidad de los paneles obtendrán años de ventaja competitiva gracias a mejores datos, mientras que los competidores seguirán tomando decisiones basadas en datos ficticios.
Preguntas frecuentes
¿Qué porcentaje de las respuestas a las encuestas realizadas mediante paneles de acceso heredados son fraudulentas?
Las estimaciones de la industria indican que las respuestas fraudulentas en los paneles de acceso tradicionales oscilan entre un 15 y un 40%, dependiendo de la fuente del panel y la rigurosidad de la verificación. En los encuestas de alto valor (B2B, profesionales de la salud) se registran tasas de fraude superiores al 50%, ya que los montos de incentivos atraen a estafadores más sofisticados y redes de bots que se apuntan a paneles premium.
¿Cómo evitan los bots de encuestas los controles tradicionales de atención?
Los bots de encuesta modernos utilizan visión por computadora para resolver CAPTCHA, al azarizar el tiempo de respuesta para imitar el comportamiento humano y emplear modelos de lenguaje de gran tamaño para generar respuestas abiertas y contextualmente apropiadas. Analizan la lógica de las preguntas para proporcionar respuestas coherentes a través de trampas de validación que podrían detectar bots simples.
¿Qué es la toma de muestras de ríos y cómo se diferencia de la toma de muestras por panel?
La obtención de datos de muestreo de ríos se basa en la recopilación de respuestas a través del tráfico web en vivo a través de redes publicitarias y asociaciones con editores, capturando a los usuarios en contextos de navegación naturales en lugar de reclutar panelistas previamente registrados. Este método reduce la contaminación de los encuestadores profesionales y proporciona acceso a audiencias más difíciles de alcanzar que nunca se incorporan a los paneles tradicionales.
¿Pueden los cuestionarios sintéticos de IA reemplazar a los participantes humanos en encuestas?
Los cuestionarios sintéticos de IA pueden simular segmentos demográficos y responder a patrones basados en datos de entrenamiento, pero no pueden captar la experiencia humana auténtica, los matices emocionales ni las actitudes emergentes que no están presentes en los conjuntos de datos históricos. Su utilidad más significativa radica en la ampliación de datos para pruebas de escenarios, y no en sustituir la investigación humana principal.
¿Cuáles son las métricas de comportamiento que detectan de forma más confiable a los encuestados fraudulentos?
La variabilidad en el tiempo de respuesta, la consistencia de la huella digital del dispositivo, la alineación de la geolocalización IP con los datos demográficos declarados, la naturalidad del movimiento del ratón y los patrones de participación en encuestas cruzadas son los indicadores más confiables de fraude. Los encuestados fraudulentos presentan una coherencia estadísticamente improbable en la velocidad y participan en volúmenes de encuestas inusualmente altos en múltiples plataformas.
¿Cuánto cuesta anualmente la fraude en encuestas a las empresas?
La fraude en encuestas cuesta a las empresas aproximadamente $4,8 mil millones al año en gastos de investigación desperdiciados y decisiones estratégicas erróneas basadas en datos contaminados. Esta cifra incluye los costos directos de la investigación, los costos de oportunidad derivados de decisiones erróneas de entrada al mercado y los fracasos de productos derivados de datos de preferencias fraudulentos.