L’industrie de la recherche de marché considère les données synthétiques comme une question avec une réponse binaire : fonctionne-t-elle ou non ? La question plus productive est plus étroite et plus précise : dans quelles conditions elle produit-elle de la connaissance par rapport à l’apparition de cette connaissance ?
Cette distinction est importante sur le plan opérationnel car une étude frauduleuse de données synthétiques et une étude rigoureuse peuvent avoir une présentation identique. Le même format de rapport professionnel, les mêmes visualisations et les mêmes tableaux statistiques. La différence entre elles n’est pas visible dans le produit final. Elle se situe dans la relation entre ce que prétendent faire les données synthétiques et la réalité des données sous-jacentes.
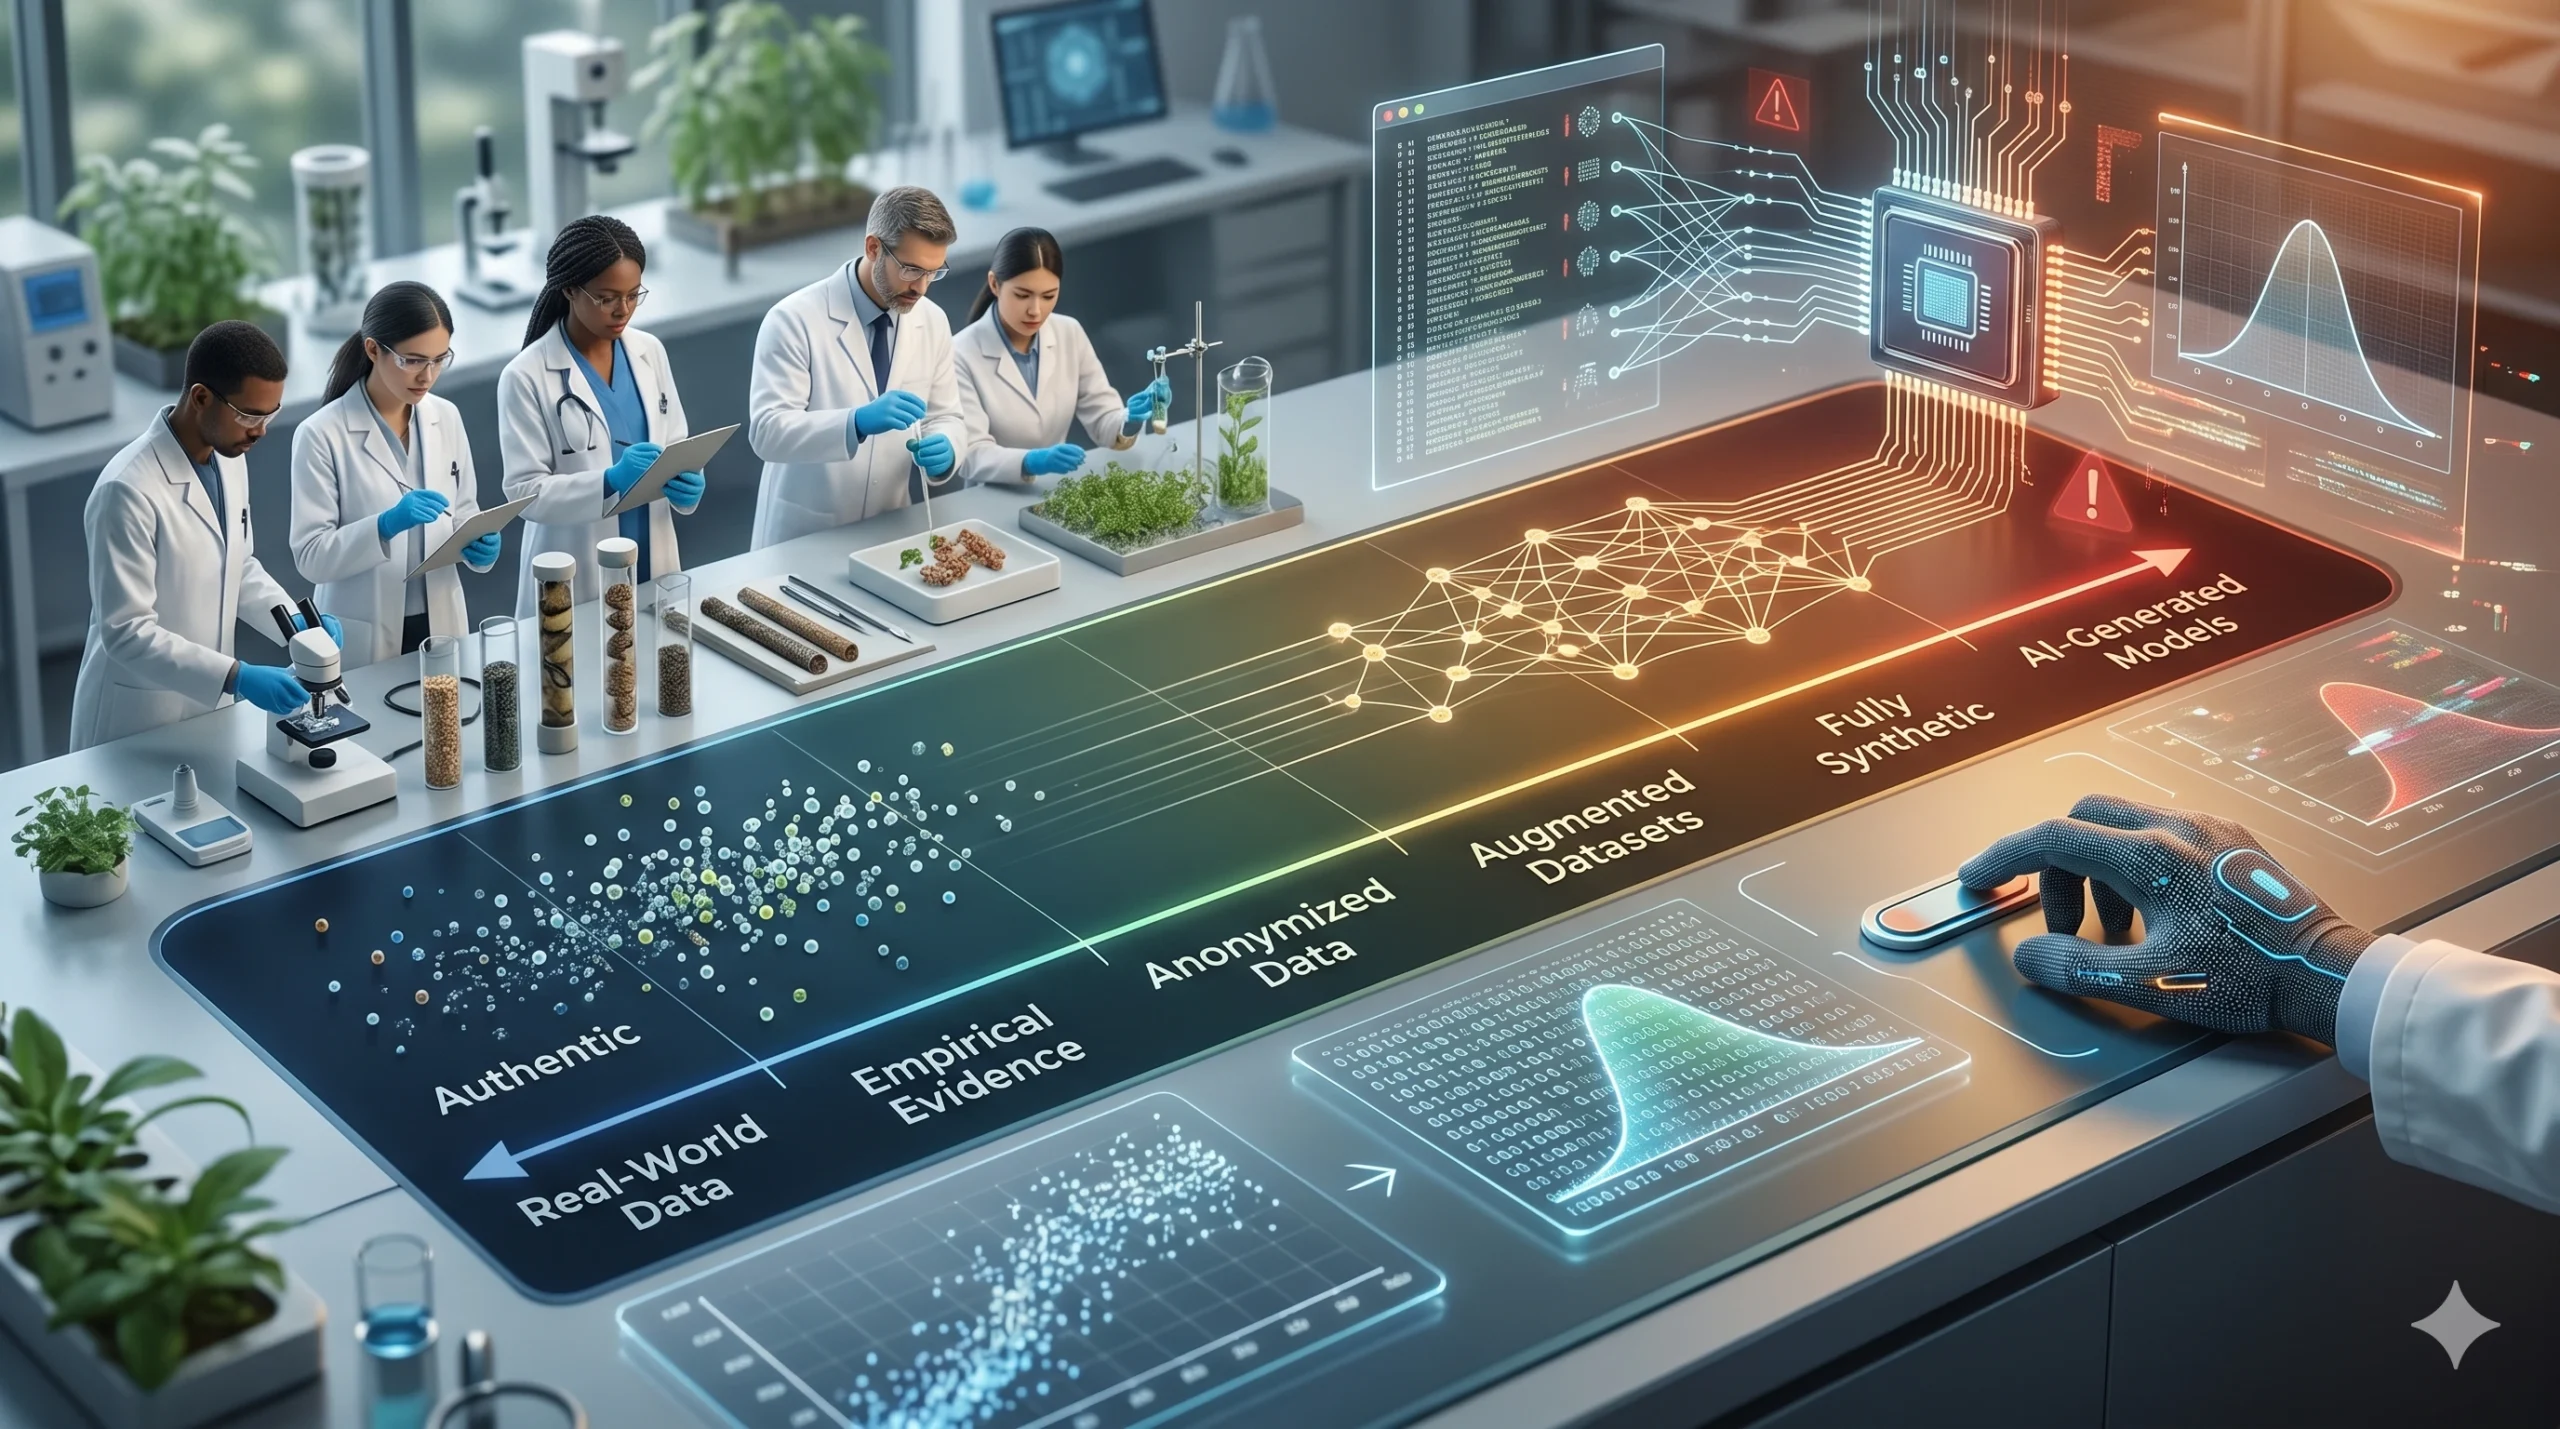
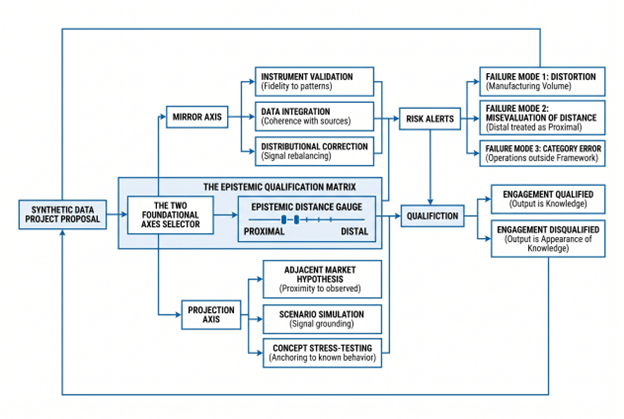
Le cadre présenté ici identifie deux axes fondamentaux : Mirror et Projection, qui organisent toutes les utilisations légitimes de données synthétiques en recherche de marché. Six positions spécifiques de recherche opèrent dans ces axes. Chaque position présente des conditions de validité explicites. Trois modes d’échec permettent de déceler toutes les situations où les données synthétiques produisent des résultats statistiques cohérents mais épistémologiquement invalides. Le cadre n’est ni une défense des données synthétiques ni une critique. Il s’agit d’un test de qualification : l’engagement est soit positif, soit négatif.
Découvrez les solutions de recherche de marché IA intelligentes d’h-in-q
Les deux axes fondamentaux : l’image et la projection
Toutes les applications légitimes des données synthétiques en recherche de marché impliquent l’une des deux opérations épistémologiques fondamentales.
Mirroir Il recouvre tous les cas où les données synthétiques reflètent ce qui est déjà connu sur une population ou un marché ; l’application de cette connaissance permet de tester un instrument, d’intégrer des ensembles de données partiels ou de corriger un déséquilibre structurel. La valeur n’est pas une nouveauté. C’est une application contrôlée des connaissances existantes visant à révéler ce que cette connaissance implique déjà.
Projection Il englobe toutes les utilisations dans lesquelles les données synthétiques étendent les connaissances sur une population ou un marché à des territoires adjacents qui n’ont pas encore été directement observés, générant des hypothèses sur la manière dont cette population pourrait réagir à de nouvelles conditions, de nouveaux concepts ou de nouvelles structures du marché. La valeur n’est pas une prévision de la demande. C’est une hypothèse structurée ancrée dans des données réelles, à tester et à valider avant qu’elle ne soit prise en compte dans une décision d’entreprise.
La distinction entre ces deux opérations est catégorique et opérationnellement importante. Une opération Mirror réussit ou échoue en fonction de sa fidélité aux données source. Une opération Projection réussit ou échoue en fonction de sa proximité aux données source ; à quel point le territoire non observé est proche du territoire observé à partir duquel il est extrapolé.
Six postes de recherche : cartographiant les axes
Dans le cadre de ces deux axes, la pratique de la recherche a documenté six positions distinctes où les données synthétiques sont légitimement appliquées en recherche de marché. La liste qui suit n’est pas exhaustive ; d’autres positions peuvent exister en fonction du contexte de la recherche, de la structure des données et des objectifs analytiques, mais ces six positions représentent les applications les plus courantes et les mieux caractérisées.
MIRROR AXIS
Position 1 : Validation des instruments – Logiciel de test de stress – Prise en charge des tâches avant le travail sur le terrain
Avant de déployer un outil de sondage auprès de répondants réels, l’analyse de populations synthétiques en lui permet de repérer des failles invisibles sur le papier. Les circuits de réponse à des questions répétitives qui bloquent les répondants dans des situations impossibles à résoudre. La réponse à la fatigue liée à l’augmentation du nombre de questions à chaque fois. L’organisation séquentielle des questions qui crée des interférences cognitives. La logique de filtrage qui exclut les segments prévus.
C’est l’application de données synthétiques présentant le plus faible risque car toute la proposition de valeur est négative : l’objectif n’est pas de découvrir ce que pensent les répondants, mais de prévenir le défaut de l’instrument lorsqu’il rencontre ce que les répondants pensent réellement.
Un programme de recherche en services financiers testant un nouveau questionnaire sur la prise de décision en matière d’investissement passe en revue 500 répondants fictifs avant d’effectuer l’examen éthique. Cette phase de tests fictifs révèle un problème de routage dans la section 4 qui aurait invalidé l’analyse comparative entre les segments réceptifs au risque et les segments réticents à celui-ci. Récupérer ce problème grâce à des répondants fictifs coûte presque rien. Le problème serait détecté après 800 entretiens réels avec des investisseurs, ce qui nécessiterait une refonte complète du questionnaire.
La condition de validité pour cette position est la précision : la population synthétique doit se comporter de manière cohérente avec les schémas documentés chez le public cible. La validation par des données réelles retenues à titre de contrôle n’est pas facultative ; c’est la manière dont l’opération prouve qu’elle accomplit ce qu’elle prétend.
Position 2 : Intégration des données – fusion de ensembles de données partiels pour obtenir une représentation cohérente
Les connaissances en matière de recherche pertinentes à une question stratégique sont souvent distribuées sur plusieurs ensembles de données générés à différents moments, par différents groupes d’experts. Aucun d’eux ne suffirait à lui seul. Un détaillant menant une analyse de croissance de sa catégorie pourrait disposer de données d’utilisation et d’attitudes issues des deux dernières années, de données de suivi des marques issues du trimestre précédent et de données de transaction au point de vente. Chacune de ces données contient un véritable signal. Ensemble, elles pourraient répondre à la question stratégique ; si les populations sous-jacentes pouvaient être réconciliées pour former une représentation cohérente.
Les données synthétiques permettent cette conciliation. En générant une population unifiée dont les propriétés statistiques sont cohérentes avec tous les ensembles de données sources simultanément, cette opération d’intégration permet d’obtenir des connaissances que aucun ensemble de données individuel ne peut fournir seul. Ce n’est pas de la fabrication de connaissances ; c’est l’intégration des connaissances existantes qui étaient auparavant inaccessible car fragmentées.
Un fournisseur de technologie B2B dispose de trois sources de données : des entretiens structurés avec douze leaders d’opinion clés, des données d’enquêtes comportementales d’un panel de responsables des achats et des données secondaires issues de rapports industriels. L’opération d’intégration crée une population cohérente compatible avec les trois sources simultanément ; ce qui permet d’effectuer des analyses de segmentation que aucune source individuelle ne pourrait réaliser.
La condition de validité de cette position est la cohérence : le ensemble de données intégré doit être statistiquement cohérent avec tous les ensembles de données source. Dans les cas où les ensembles de données source sont véritablement contradictoires, cette contradiction doit être signalée, et non une différence à résoudre par le modèle synthétique.
Position 3 : Correction distributive – Rééquilibrage de la prédisposition de l’échantillon à l’aide d’un signal réel
Le biais de recrutement est une caractéristique de tout programme de recherche à grande échelle. Les panels en ligne sous-représentent les répondants urbains, issus d’une classe sociale instruite et ayant un revenu élevé. Les études B2B sous-représentent les grandes entreprises par rapport à la répartition réelle des tailles d’organisations. Ces biais sont connus et documentés au moment de la collecte des données, mais n’ont pas été abordés car corriger ces biais par des recrutements supplémentaires est prohibitif en termes de coûts.
La correction synthétique permet de rééquilibrer les profils lorsque le recrutement ne le nécessite pas. En générant des profils synthétiques pour les segments sous-représentés, en s’appuyant sur des signaux réels présents dans les données de source concernant ces segments, la répartition peut être rééquilibrée vers la structure réelle de la population.
Une étude de la consommation au détail, qui a enregistré une surreprésentation documentée de consommateurs urbains aisés, utilise des données réelles provenant des segments sous-représentés présents dans l’échantillon pour générer des profils synthétiques qui restituent la répartition aux proportions réelles du marché. Une enquête de la consommation auprès des entreprises manufacturières, qui présente un faible taux de réponse, génère des profils synthétiques des entreprises manufacturières conformes aux répondants réels issus de ces entreprises, rééquilibrant ainsi la répartition en fonction de la taille de l’entreprise.
La condition de validité de cette position est stricte : les données sources doivent déjà contenir un signal véritable concernant les segments à corriger. Une étude peut être corrigée en fonction du poids réel d’un groupe démographique présent dans l’échantillon réel, même s’il est sous-représenté. Elle ne peut pas être corrigée en fonction d’un groupe démographique auquel les données sources ne touchent presque pas ; cela nécessiterait une opération différente soumise à des conditions différentes.
axe de projection
Position 4 : Hypothèse du marché adjacent : projection vers des marchés proches à partir de marchés connus
Une entreprise de produits de consommation souhaite comprendre comment les structures de tarification qui fonctionnent dans le secteur de la bière de qualité supérieure pourraient s’appliquer au cidre de qualité supérieure ; une catégorie pour laquelle les données d’étude historiques sont moins abondantes mais les habitudes de consommation sont voisines. Une entreprise de services financiers souhaite modéliser la manière dont la prise de décision concernant l’adoption d’un nouveau régime de retraite au sein de l’entreprise pourrait différer des habitudes de prise de décision relatives aux régimes existants. Une entreprise de santé souhaite projeter les schémas de prise de décision en matière de soins primaires à partir des contextes de tarification payante vers des modèles de paiement fondés sur la valeur ajoutée.
Dans chaque cas, la projection s’appuie sur des données comportementales ou d’attitudes abondantes issues d’un marché connu et étende cette connaissance à un marché suffisamment proche de la source pour que les données d’entraînement contiennent un signal authentique concernant les phénomènes qui sont modélisés. La sortie n’est pas une prévision de la demande. C’est une carte d’hypothèses priorisées : où s’attendre à une adoption, où à une résistance, quels segments sont les plus susceptibles d’être impliqués.
La condition de validité de cette position est la proximité : le territoire non observé doit être suffisamment proche du territoire observé pour que les données d’entraînement contiennent un signal significatif. Une projection de la bière vers le cidre est valide. Une projection de la bière vers les crypto-monnaies n’en est pas la même ; le mécanisme de prise de décision des consommateurs est fondamentalement différent.
Position 5 : Simulation de scénario : Test des changements limités dans des contextes complexes
La recherche B2B nécessite souvent de comprendre la manière dont les décideurs réagissent à des scénarios qui n’ont pas encore eu lieu ou qui se sont produits une seule fois dans l’histoire. Une entreprise de technologie logistique modélise la manière dont les décideurs en matière d’approvisionnement chez les fabricants de milieu de gamme réagiraient à une plateforme automatisant le changement de fournisseur dans des conditions de disruption de l’approvisionnement. Une entreprise de technologie médicale simule la manière dont les responsables des hôpitaux réagiraient à des incitations de remboursement changeantes. Une société de logiciels de fabrication projette les tendances d’adoption d’un outil permettant d’automatiser la planification de la production dans des scénarios de pénurie de main-d’œuvre.
Cette projection s’appuie sur un comportement de prise de décision largement documenté. analogue Les pressions ; les problèmes d’approvisionnement, les escalades de coûts, les contraintes opérationnelles… Cela étend cette connaissance à un scénario spécifique et nouveau. La sortie est une carte des schémas de réponse probables, et non une prévision de ce qui se produira.
La condition de validité de cette position est la connexion du signal à la masse : les données d’entraînement doivent contenir des données comportementales ou comportementales réelles sur les mécanismes de prise de décision projetés, même si elles ne contiennent pas de données sur le scénario spécifique. Une projection basée sur le comportement d’achat historique dans des contraintes de ressources est valide. Une projection basée sur les attitudes générales des entreprises face à un scénario technologique novateur n’en est pas.
Position 6 : Test de résistance conceptuelle : Test de résistance de produits hypothétiques et positionnement sur des marchés synthétiques
Avant de consacrer un budget de terrain à un test complet d’un concept, les populations synthétiques permettent de modéliser la manière dont un segment défini pourrait réagir à un nouveau concept de produit, à un nouveau positionnement de marque ou à une nouvelle entrée dans une catégorie. Le test de stress du marché synthétique permet de repérer les points fragiles du concept : points de refus de prix, inadaptation des caractéristiques, désalignement du segment, faible prix et lancement prématuré.
Une entreprise de produits de consommation emballés met à l’épreuve par stress-tests une nouvelle extension de gamme en utilisant trois angles de positionnement potentiels, en utilisant des populations de répondants constituées à partir de données historiques relatives aux essais de produits et à la perception de la marque. Une entreprise de SaaS teste trois propositions de valeur différentes en utilisant des profils de consommateurs constitués à partir de la segmentation des clients existants et de recherches sur le positionnement concurrentiel. Une entreprise de services financiers modélise la manière dont différents segments de clients réagiraient à une nouvelle structure d’encadrement grâce à des populations constituées à partir de données comportementales et d’attitudes existantes.
La condition de validité de cette position est l’ancrage : la population synthétique doit être fondée sur des données réelles concernant les phénomènes que le concept vise ; les comportements existants dans la catégorie, les perceptions existantes concernant la marque, les schémas de prise de décision existants, et non sur le concept lui-même, qui est novateur. La sortie est une hypothèse sur l’endroit où le terrain réel devrait être mené, et non une prédiction de l’issue de ce travail de terrain.
Pourquoi ces six personnes, et y en a-t-il d'autres ?
Les six positions décrites ci-dessus représentent les applications les plus documentées de données synthétiques dans le domaine de la recherche de marché. Elles sont bien caractérisées, possèdent des conditions d’adéquation explicites et produisent des résultats validés en fonction des résultats de recherches réels.
Des positions supplémentaires peuvent exister. Un contexte de recherche impliquant des structures de données différentes, des populations différentes ou des objectifs analytiques différents pourrait soutenir d'autres applications légitimes. Ce cadre n'est pas présenté comme exhaustif. Il s'agit plutôt d'un aperçu du terrain connu, des positions où les données synthétiques ont démontré leur utilité et où les conditions de validité sont bien connues.
Lorsque l’engagement concernant des données synthétiques ne peut pas être clairement identifié dans l’un de ces six cas, ou lorsque cela nécessite une extension au-delà des conditions de validité énoncées, la position par défaut est que cela nécessite une justification supplémentaire explicite au-delà du cadre standard.
L'ancrage de la validité : distance épistémique
Les quatre opérations – Mirror, Synthèse, Correction, Projection – sont conditionnées par une seule variable : la distance entre les données d’entraînement et la population ou le phénomène à modéliser.
Distance proximale, La population ou le phénomène modelé est bien représenté dans les données d'entraînement, où les six positions sont toutes valables.
Distance distale, Lorsque la population ou le phénomène étudié n’est pas représenté ou n’est pas présent dans les données d’apprentissage, tous les six paramètres deviennent problématiques, quelle que soit la cohérence statistique de la représentation synthétique.
La variable distance n'est pas liée à la similitude démographique. Elle concerne plutôt la question de savoir si les données d'entraînement contiennent un véritable signal indiquant une différence entre les deux groupes. Mécanismes entraîner le comportement modelé. Une position qui serait valide pour une population bien documentée devient invalide pour une population que les données d’entraînement ne touchent presque pas. Une projection qui serait légitime pour un marché voisin devient illégale pour un marché éloigné.
C’est là que naissent les modes de défaillance les plus courants, non pas à cause des positions elles-mêmes, mais en raison d’une mauvaise estimation de la distance entre ce que les données d’entraînement savent et ce que le modèle doit générer.
Trois modes d'échec : lorsque les engagements échouent lors de l'essai
Tout usage abusif de données synthétiques dans le cadre d’études de marché échoue au test de qualification de trois manières.
Mode d’erreur 1 : Distortion – Volume de production au lieu de connaissances
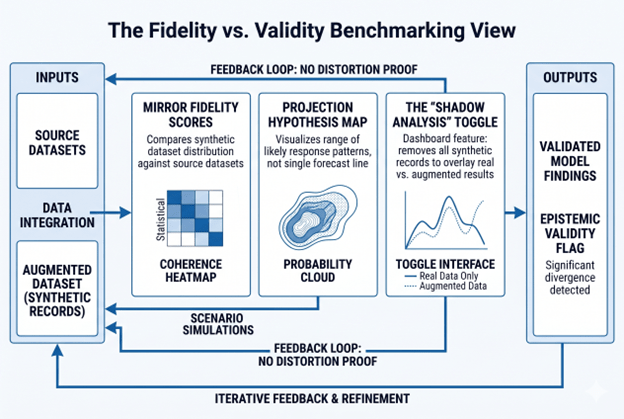
La plus fréquente des erreurs d’utilisation se présente sous la forme de Position 3 (Correction distributive), mais elle effectue une opération entièrement différente : elle amplifie le volume mathématique afin d’atteindre un seuil statistique que les données réelles ne peuvent pas supporter.
Une équipe de recherche recueille N=40 réponses réelles sur un segment B2B spécifique. Quelqu’un propose de générer N=2 960 enregistrements synthétiques à partir du même modèle de population pour atteindre N=3 000 ; cela permet d’atteindre la puissance statistique requise pour l’analyse du sous-groupe visé par le brief. Les enregistrements synthétiques ne contiennent aucune information supplémentaire. Ils sont 2 960 réflexions mathématiques de ce que les 40 répondants originaux ont dit. La variance est une variance modélisée, limitée par les 40 répondants originaux. Les intervalles de confiance sont étroits car l’échantillon est formellement plus important. Le signal du marché sous-jacent reste inchangé car l’échantillon synthétique est dérivé.
Une marque de cosmétiques a utilisé cette approche pour une étude d’extension de la gamme de couleurs. L’échantillon synthétique augmenté a montré une forte intention d’achat dans trois nouveaux groupes de couleurs. Les N=40 réels derrière le modèle étaient concentrés dans un sous-ensemble démographique précis. Au lancement, les performances des couleurs étaient très inégales ; fortes là où les 40 originaux étaient représentatives, faibles partout où l’augmentation synthétique semblait valider la situation. L’intervalle de confiance s’était rétréci. Le marché avait raconté une autre histoire.
Le diagnostic est simple : éliminer toutes les données synthétiques et analyser uniquement les données réelles. Si les résultats sont cohérents, l’augmentation n’était pas nécessaire. Si elle s’avère erronée, l’augmentation n’a pas résolu un problème statistique ; elle a simplement caché un manque de connaissances.
Mode d’échec 2 : sous-évaluation de la distance – traitant le distal comme proximal
Le deuxième mode de défaillance est plus subtil : l’engagement occupe la bonne position, mais les données d’entraînement sont beaucoup plus éloignées de la population cible que l’analyse le suppose.
Une société pharmaceutique étudie la prise de décisions en matière de traitement chez les oncologues des marchés émergents. Le recrutement réel est lent. La solution : renforcer le personnel avec des médecins synthétiques générés à partir d’un modèle formé principalement sur des données d’oncologues américains et européens. Les oncologues synthétiques passent les contrôles de validation standard. Ils se comportent de manière cohérente avec ce que le modèle sait. Le problème : ce que le modèle sait, c’est ce que les oncologues américains et européens exerçant dans des systèmes de santé fondamentalement différents ont déclaré. Ce modèle ne contient aucune indication concernant les contraintes institutionnelles, économiques ou culturelles qui orientent la prise de décision dans les marchés cibles.
Une entreprise de SaaS B2B met à l’épreuve un modèle de tarification pour un segment de marché que les données d’entraînement ne représentent à peine. Une entreprise de biens de consommation génère des répondants synthétiques pour un concept qui n’a pas d’analogue historique dans les données d’entraînement. Dans chaque cas, cette opération serait valide si la distance était proximale. Elle devient invalide lorsque la distance est distale mais est traitée comme étant proximale.
Le test pour ce mode de défaillance consiste à poser une seule question avant de lancer l’engagement : les données de formation contiennent-elles un signal authentique concernant les mécanismes qui conduisent le comportement modelé, pour la population visée ? Si la réponse est négative, l’engagement échoue au test, quelle que soit la position qu’il prétend occuper.
Mode d’échec 3 : Erreur de catégorie – Opérations hors cadre
Le troisième mode d’échec concerne des opérations qui ne sont pas incluses dans le cadre du système ; des actions qui ne sont pas Mirror, Synthèse, Correction ou Projection, et donc pas l’une des six positions.
La génération de personnalités synthétiques à partir d’un modèle linguistique de grande taille sans une base de données structurée constituée de données réelles est un exemple courant. Un modèle d’IA génératif qui est invité à simuler la réaction d’un segment cible à une brève ne réalise pas un Mirror ; il n’a pas de structure source pour refléter cette réponse. Il ne réalise pas de Projection ; il n’a pas non plus de données de formation proximales pour étendre cette simulation. Il génère des langages statistiquement cohérents avec la brève, ce qui est une opération différente de la génération de données statistiquement cohérentes avec une population.
La prévision de la demande présentée comme une constatation de recherche est un autre exemple. Une projection valide génère un schéma hypothétique pour une étude de terrain réelle afin de la valider. La même projection, présentée comme une prévision ; une courbe de demande prédite, une projection de chiffre d’affaires, un feu vert pour le lancement d’un produit, constitue une erreur de catégorie. L’opération passe de la génération d’hypothèses à l’entrée des décisions commerciales, ce qui modifie le statut épistémique de la sortie.
Le « twin » numérique d’un individu connu, la génération de réponses synthétiques à des concepts dépourvus de précédents historiques, l’effort visant à remplacer la recherche qualitative par des entrevues avec des répondants synthétiques ; ces opérations ne peuvent pas être qualifiées dans le cadre de cette discipline car elles ne sont pas des applications épistémologiquement valables de la génération de données synthétiques.
Implica-tions pour la gouvernance de la recherche
Moins de 22% des équipes de recherche d’entreprise disposent d’une politique documentée concernant l’utilisation des données synthétiques. C’est là que réside le problème : un chercheur sans cadre de travail se tourne vers les données synthétiques car elles sont rapides et peu coûteuses, et non parce que l’application satisfait aux critères de qualification.
Les deux axes et les six positions constituent la structure d'un processus de qualification. Avant toute mise en œuvre de données synthétiques, trois questions doivent être répondues :
Quelle position occupe cette entente ? Si l’engagement ne peut pas être clairement identifié comme l’un des six ; ou comme une autre position ayant des conditions de validité clairement définies, l’engagement échoue avant que la génération synthétique ne commence.
Les données d’entraînement sont-elles proches de la population et des phénomènes qui sont modélisés ? Proximal signifie que les données contiennent un signal authentique concernant les mécanismes modélisés. Si la réponse honnête est non, l’engagement échoue quelle que soit la position.
Quel est le statut épistémique de la production ? Les résultats des miroirs informent les décisions dans le cadre des données réelles qu’ils capturent. Les résultats de la projection constituent des hypothèses à tester lors de travaux de terrain réels. Si l’utilisation prévue de ces résultats ne correspond pas à leur statut épistémique, l’engagement est disqualifié.
Les programmes de recherche qui appliquent ce processus de qualification avant la mise en service auront moins de missions de nature artificielle. Les missions qui seront menées produiront des résultats capables de résister à la concurrence du marché.
Outils, notes techniques et contexte
Les six positions nécessitent des approches techniques différentes. Les choix des outils influencent autant la validité de l’opération que la conception conceptuelle.
Pour Positionnements des miroirs (Validation, intégration, correction), la condition centrale est la mesure de la fidélité et la validation de la cohérence. La plupart des outils d’intelligence artificielle et de Gretel proposent des paramètres de fidélité configurables pour les données tabulaires. Qualtrics et Ipsos documentent des méthodologies de fusion de données pour une intégration à grande échelle. La littérature classique en statistique sur le resampling et la post-stratification couvre les méthodologies de correction.
Pour Positionnements de projection (Markets adjacents, simulation de scénarios, test de concepts), la condition requise est la mise à la terre des signaux et la validation des données réelles. Chaque sortie de Projection doit être testée contre des données réelles issues du terrain avant d’être prise en compte dans une décision commerciale. Le cas EY ; où les réponses synthétiques formées à partir de données réelles issues d’enquêtes auprès des dirigeants ont été comparées à la sortie réelle de l’enquête à 95%, représente un standard d’excellence en matière de fidélité, et non une licence pour remplacer les enquêtes réelles.
La distinction entre la génération basée sur des LLM et les modèles ML structurés entraînés sur des données réelles est cruciale : les LLM sans ancrage de données fonctionnent complètement hors du cadre.
👉 [Liens internes : “ Méthodologie de recherche du marché de l’IA ” → / blog/outils de recherche du marché de l’IA]
Questions fréquemment posées
Q : Qu’est-ce que les données synthétiques en recherche de marché ? A: Les données synthétiques dans le cadre de la recherche de marché sont des données générées artificiellement qui reproduisent les schémas statistiques d’une population réelle sans conserver les réponses réelles de chaque répondant. Elles sont produites en entraînant un modèle génératif sur des données réelles et en utilisant ce modèle pour créer de nouveaux enregistrements. Ses applications légitimes fonctionnent selon deux axes fondamentaux, le Miroir (réflectant ce qui est connu) et la Projection (prolongant ce qui est connu vers des hypothèses adjacentes), ainsi que six positions documentées dans ces axes.
Q : Quand faut-il utiliser des données synthétiques pour la recherche ? A: Les données synthétiques ont des applications de recherche légitimes dans les six positions documentées dans ce cadre, trois ancrées dans l’axe Miroir et trois dans l’axe Projection. Chaque position a des conditions de validité explicites liées à la proximité des données d’entraînement avec la population à modéliser. Une interaction qui ne peut pas être clairement identifiée dans l’une de ces positions, ou qui implique des populations trop éloignées des données d’entraînement, relève du cadre d’application légitime.
Q: Quels sont les risques liés aux données synthétiques dans le cadre de la recherche auprès des consommateurs ? A: Les trois principaux modes de failles sont : distorsion (production d’un volume mathématique pour atteindre des seuils de signification statistique sans ajouter de connaissances sur le marché), sous-évaluation de la distance (traitement des populations ou des phénomènes que les données d’entraînement ne représentent guère comme si elles étaient bien représentées), et erreur de catégorie (exécution d’opérations qui ne sont pas Mirror, Synthèse, Correction ou Projection, et donc en dehors de la méthodologie de recherche légitime). Chacune de ces erreurs produit des résultats qui peuvent sembler cohérents statistiquement, mais qui sont par ailleurs éthiquement invalides.
Q: Les données synthétiques peuvent-elles remplacer les répondants réels d’un sondage ? A: Non. Les six positions légitimes reposent soit sur des données réelles des répondants (les positions Mirror), soit nécessitent des données réelles des répondants pour valider l’hypothèse (les positions Projection). Les données synthétiques contribuent à leur place méthodologique à rendre la collecte de données réelles plus ciblée, plus efficace et mieux conçue, et non à les éliminer.
Q: Comment puis-je savoir si les données synthétiques sont valables ? A: La validité est déterminée par trois facteurs : le positionnement de l’engagement dans l’un des six positions (ou dans une autre position explicitement justifiée), le fait que les données d’entraînement soient suffisamment proches de la population à modéliser et le fait que l’utilisation prévue de la sortie corresponde à son statut épistémique. Un engagement qui échoue à l’un de ces trois tests est invalide, quelle que soit la cohérence statistique de la sortie synthétique.
Q: Quelle est la différence entre l’augmentation des données synthétiques et la fraude ? A: La correction légitime (position 3) amplifie le signal réel qui existe déjà dans les données de source, rééquilibrant la distribution vers sa véritable structure de population à l’aide de données authentiquement collectées. L’augmentation frauduleuse augmente la taille d’une échantillon afin d’atteindre des seuils statistiques que les données réelles ne peuvent pas supporter, amplifiant ainsi le volume mathématique plutôt que la connaissance du marché. La distinction dépend entièrement de savoir si le signal amplifié est réel ou généré à partir de rien.
Conclusion
Le débat sur les données synthétiques en recherche de marché ne sera pas résolu par de meilleures technologies. Des algorithmes plus performants et une génération de plus haute fidélité ne résolvent pas le problème fondamental : la validité épistémique des résultats dépend de la relation entre ce que les données d’entraînement savent et ce que le modèle doit générer.
Les deux axes et les six positions décrits ici définissent les situations où les données synthétiques permettent de produire des connaissances plutôt que de semer le doute. Chaque position est accompagnée de conditions de validité explicites. Les trois modes de défaillance rendent compte de tous les cas documentés de mauvaise utilisation des données synthétiques dans la recherche commerciale. Le cadre n’exige pas que les praticiens soient partisans ou sceptiques des données synthétiques. Il exige simplement qu’ils soient précis quant à ce qu’ils affirment et que les preuves soient à l’appui de cette affirmation.
Les données synthétiques sont un outil de recherche légitime pour exactement deux choses : refléter ce qui est déjà connu et étendre ce qui est déjà connu pour inclure ce qui n'a pas encore été observé.
👉Méthodologie de recherche du marché de l'IA
👉Des outils d'analyse alimentés par l'IA pour les équipes du MENA
👉BuzzPulse-in-Q pour l’intelligence de la recherche
👉10 façons dont l’IA va changer la recherche auprès des consommateurs en 2026
👉Recherche de marché en IA pour les petites entreprises
FAQ : Données synthétiques dans la recherche de marché
Les données synthétiques dans la recherche de marché
Qu’est-ce que les données synthétiques dans la recherche de marché ?
Les données synthétiques dans le cadre de la recherche de marché sont des données générées artificiellement qui reproduisent les schémas statistiques d'une population réelle sans conserver les réponses réelles de chaque répondant. Elles sont produites en entraînant un modèle génératif sur des données réelles et en utilisant ce modèle pour créer de nouveaux enregistrements. Ses applications légitimes fonctionnent selon deux axes fondamentaux, le Miroir (réflectant ce qui est connu) et la Projection (prolongant ce qui est connu vers des hypothèses voisines), ainsi que six positions documentées dans ces axes.
Quand devriez-vous utiliser des données synthétiques pour votre recherche ?
Les données synthétiques ont des applications de recherche légitimes dans les six positions documentées dans ce cadre, trois ancrées dans l’axe Miroir et trois dans l’axe Projection. Chaque position présente des conditions de validité explicites liées à la proximité des données d’entraînement avec la population à modéliser. Une interaction qui ne peut pas être clairement identifiée dans l’une de ces positions, ou qui implique des populations trop éloignées des données d’entraînement, relève du cadre d’application légitime.
Quels sont les risques des données synthétiques dans la recherche auprès des consommateurs ?
Les trois principaux modes de failles sont : distorsion (production d’un volume mathématique pour atteindre des seuils de signification statistique sans ajouter de connaissances du marché), sous-évaluation de la distance (traitement des populations ou des phénomènes que les données d’entraînement ne représentent guère comme si elles étaient bien représentées), et erreur de catégorie (exécution d’opérations qui ne sont pas Mirror, Synthèse, Correction ou Projection, et donc en dehors de la méthodologie de recherche légitime). Chacune de ces failles produit des résultats qui peuvent sembler cohérents statistiquement, mais qui sont éthiquement invalides.
Les données synthétiques peuvent-elles remplacer les répondants réels d'une enquête ?
Non. Les six positions légitimes reposent soit sur des données réelles des répondants (les positions Mirror), soit nécessitent des données réelles des répondants pour valider l’hypothèse (les positions Projection). Les données synthétiques acquièrent leur place méthodologique en rendant la collecte de données réelles plus ciblée, plus efficace et mieux conçue, et non en les éliminant.
Comment savoir si les données synthétiques sont valables ?
La validité est déterminée par trois facteurs : le positionnement de l’engagement dans l’un des six positions (ou toute autre position explicitement justifiée), la proximité des données d’entraînement avec la population à modéliser, et l’utilisation prévue de la sortie correspond à son statut épistémique. Un engagement qui échoue à l’un de ces trois tests est invalide, quelle que soit la cohérence statistique de la sortie synthétique.
Quelle est la différence entre l’augmentation des données synthétiques et la fraude ?
La correction légitime (Position 3) amplifie le signal réel qui existe déjà dans les données de source, rééquilibrant la distribution vers sa véritable structure de population à l’aide de données authentiquement collectées. L’augmentation frauduleuse augmente la taille d’une échantillon afin d’atteindre des seuils statistiques que les données réelles ne peuvent pas supporter, amplifiant ainsi le volume mathématique plutôt que la connaissance du marché. La distinction dépend entièrement de savoir si le signal amplifié est réel ou généré à partir de rien.
Conclusion
Les données synthétiques ne constituent pas une seule méthode ; ce sont un éventail de techniques ayant des profils de validité radicalement différents selon l’endroit et la manière dont elles sont déployées. Le cadre à échelle glissante offre une logique décisionnelle pratique : l’Évangélisateur pour la conception avant vol, l’Optimiste pour une portabilité compatible avec la confidentialité, l’Étranglé pour les choix entre imputation classique et ML, et une position fermement Rejetante quant à l’inflation de la taille des échantillons.
Les chercheurs qui utilisent des données synthétiques les traitent bien comme un cadre, et non comme une structure. Elle construit de meilleurs instruments, protège la confidentialité des répondants à l'échelle transfrontalière et détecte les points d'inflexion avant que les travaux de terrain coûteux ne commencent. Elle ne remplace pas les 800 consommateurs réels qui vous diront quelque chose que vous n'aviez pas prévu, car rien ne le fait.
Si votre équipe doit naviguer dans les décisions méthodologiques associées à l’intégration de l’IA dans un flux de travail de recherche, déterminer où les données synthétiques s’imposent, où les données en temps réel sont incontournables et comment défendre l’une ou l’autre option devant un conseil d’administration, c’est exactement le type de programme que nous proposons. H-in-Q.com Il est conçu pour fonctionner avec vous. Réservez votre session gratuite de consultation sur la stratégie de recherche en IA →
Le marché dispose déjà de suffisamment d'études fondées sur une confiance artificielle. Élaborez celles qui tiennent la route.