Éclairer le danger des MLOps sans filiation de données
L’essor de la MLOps a transformé le déploiement de l’apprentissage automatique de simples expériences isolées en systèmes de production intégrés. Au fur et à mesure que les entreprises se développent, elles construisent des pipelines de données complexes, mettent en œuvre des modèles dans des environnements cloud et exigent des performances constantes. En même temps, le contrôle réglementaire, la pression de conformité et les responsabilités éthiques ne cessent de s’intensifier. Dans ce contexte, les outils de traçabilité des données, permettant de suivre les données depuis leur source jusqu’à leur sortie, sont souvent proposés comme la base de systèmes ML fiables. Mais l’adoption de ces outils dans la MLOps est controversée : sont-ils indispensables pour garantir la responsabilité, ou aggravent-ils la complexité et ralentissent-ils ainsi l’innovation ? Cet article met en lumière cette tension comme un choix crucial : transparence et confiance au prix de la complexité ou vitesse et simplicité avec des risques cachés.
Pourquoi MLOps a besoin de transparence ? Le cas des outils de traçabilité des données
La montée des exigences réglementaires dans le MLOps
La gouvernance des données n’est plus une option pour les organisations utilisant l’apprentissage automatique. Au fur et à mesure que le volume des données augmente, les organisations doivent garantir la qualité, la traçabilité et la conformité aux normes, depuis les audits internes jusqu’aux réglementations externes. La traçabilité des données fournit un enregistrement systématique de l’origine des données, de leur transformation et de leur parcours, permettant une gouvernance robuste des pipelines ML. techtarget.com+2ibm.com+2
Sans une traçabilité transparente, il est presque impossible de prouver que les résultats d’un modèle proviennent de données propres et approuvées ; c’est une faille fatale lors des audits ou des contrôles réglementaires. Les frameworks modernes de gouvernance des données reposent sur la traçabilité pour fournir la visibilité, la traçabilité et la responsabilité tout au long des cycles de vie des données. ibm.com+2ibm.com+2
Avantages opérationnels de la visibilité dans les workflows de machine learning
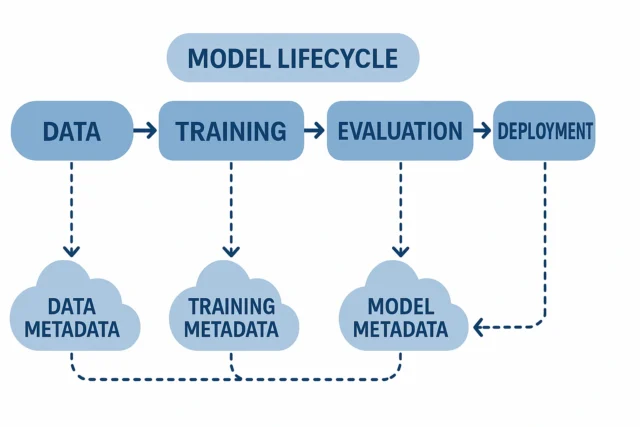
En plus de garantir la conformité, la traçabilité des données apporte une valeur opérationnelle pratique dans les workflows MLOps. Elle permet aux équipes de déboguer, reproduire et vérifier toutes les étapes du pipeline de données, depuis les données brutes jusqu’à l’inférence des modèles finalisés. neptune.ai+2ibm.com+2
- Analyse accélérée des causes profondes
- Réplication garantie de l'expérience
- Réutilisation efficace des données et des modèles
- Confiance pour les auditeurs et les autorités de réglementation
Le modèle de déploiement du cloud computing façonne le paysage de l'MLOps
Cloud public vs cloud privé dans l’intégration MLOps
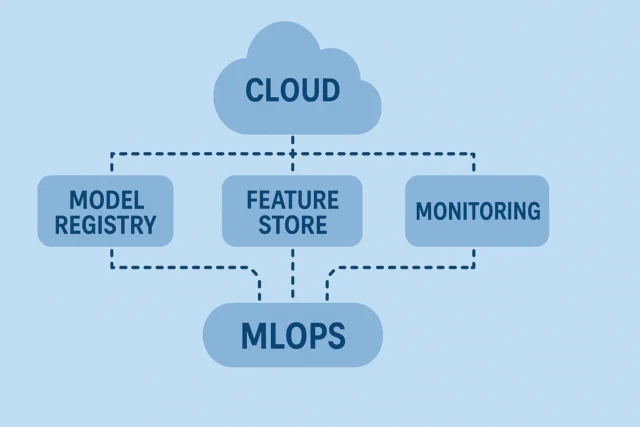
L’architecture choisie pour les charges de travail ML dans le cloud public, le cloud privé ou le hybride influe fondamentalement sur la manière dont les outils de lineage s’intègrent et fonctionnent. Dans un environnement cloud public, de nombreux services de données et de ML gérés proposent déjà une logistique de données et une gestion des versions intégrées. Cette configuration facilite la mise en œuvre des outils de lineage et en rend la gestion plus complète, car ils peuvent s’appuyer sur des infrastructures existantes plutôt que de nécessiter une configuration manuelle.
Cependant, les clouds publics comportent souvent des contraintes liées aux fournisseurs, une complexité d’analyse des données entre les services et des problèmes potentiels en matière de conformité ou de législation lorsque les données traversent des régions ou des services différents. Traiter le traçage de l’historique des données entre plusieurs services gérés peut s’avérer difficile ; les migrations ou les audits deviennent plus complexes lorsque les données circulent entre différents fournisseurs.
Les architectures hybrides et le coût de l’observabilité
| Modèle de déploiement | Facilité d’intégration dans le système de gestion de la chaîne d’approvisionnement | Problèmes d'observabilité |
| Cloud public | Haute (support natif) | Suivi transfrontalier entre services, dépendance à un fournisseur |
| Cloud privé | Medium (configuration personnalisée) | Charge élevée de maintenance |
| Hybrid/Multi-Cloud | Bas à moyen | Fragmentation des données, métadonnées incohérentes |
Le choix du modèle de déploiement façonne le calcul coûts-avantages pour la traçabilité des données dans le cadre de l’MLOps. Plus l’infrastructure est distribuée ou hybride, plus cette traçabilité est essentielle mais aussi plus coûteuse ; une bonne traçabilité devient alors un enjeu majeur.
Automatisations vs Complexité : Perdrons-nous notre contrôle dans le cadre de MLOps ?
La promesse d’une automatisation transparente dans le MLOps
Au fond de lui-même, MLOps promet une automatisation telle que l’intégration continue, la livraison continue (CI/CD), la formation automatisée, le monitoring et le déploiement, transformant ainsi la ML en systèmes évolutifs, reproductibles et de niveau production. Wikipedia+2agilelab.it+2
L’automatisation rationalise les workflows, réduit les erreurs manuelles et permet des itérations rapides. Lorsqu’on travaille avec des données volatiles, des exigences changeantes ou des modèles dynamiques, les pipelines automatisés sont la seule façon de maintenir les opérations ML à l’échelle.
Lorsque l’automatisation nuit à la clarté opérationnelle
L'introduction des outils de hiérarchie peut restaurer la transparence, mais elle comporte également des complexités propres : stockage des métadonnées, charge d'administration, suivi à travers des systèmes disparates, maintenance accrue. Dans les configurations mal gérées, la hiérarchie devient un fardeau : volumes importants de métadonnées, traitement des données plus lent et charge supplémentaire qui peuvent peser plus lourdement que la clarté apportée.
Le dilemme du Data Pipeline : traçabilité ou blocage ?
Les pipelines à plusieurs étapes et la charge de travail liée aux métadonnées
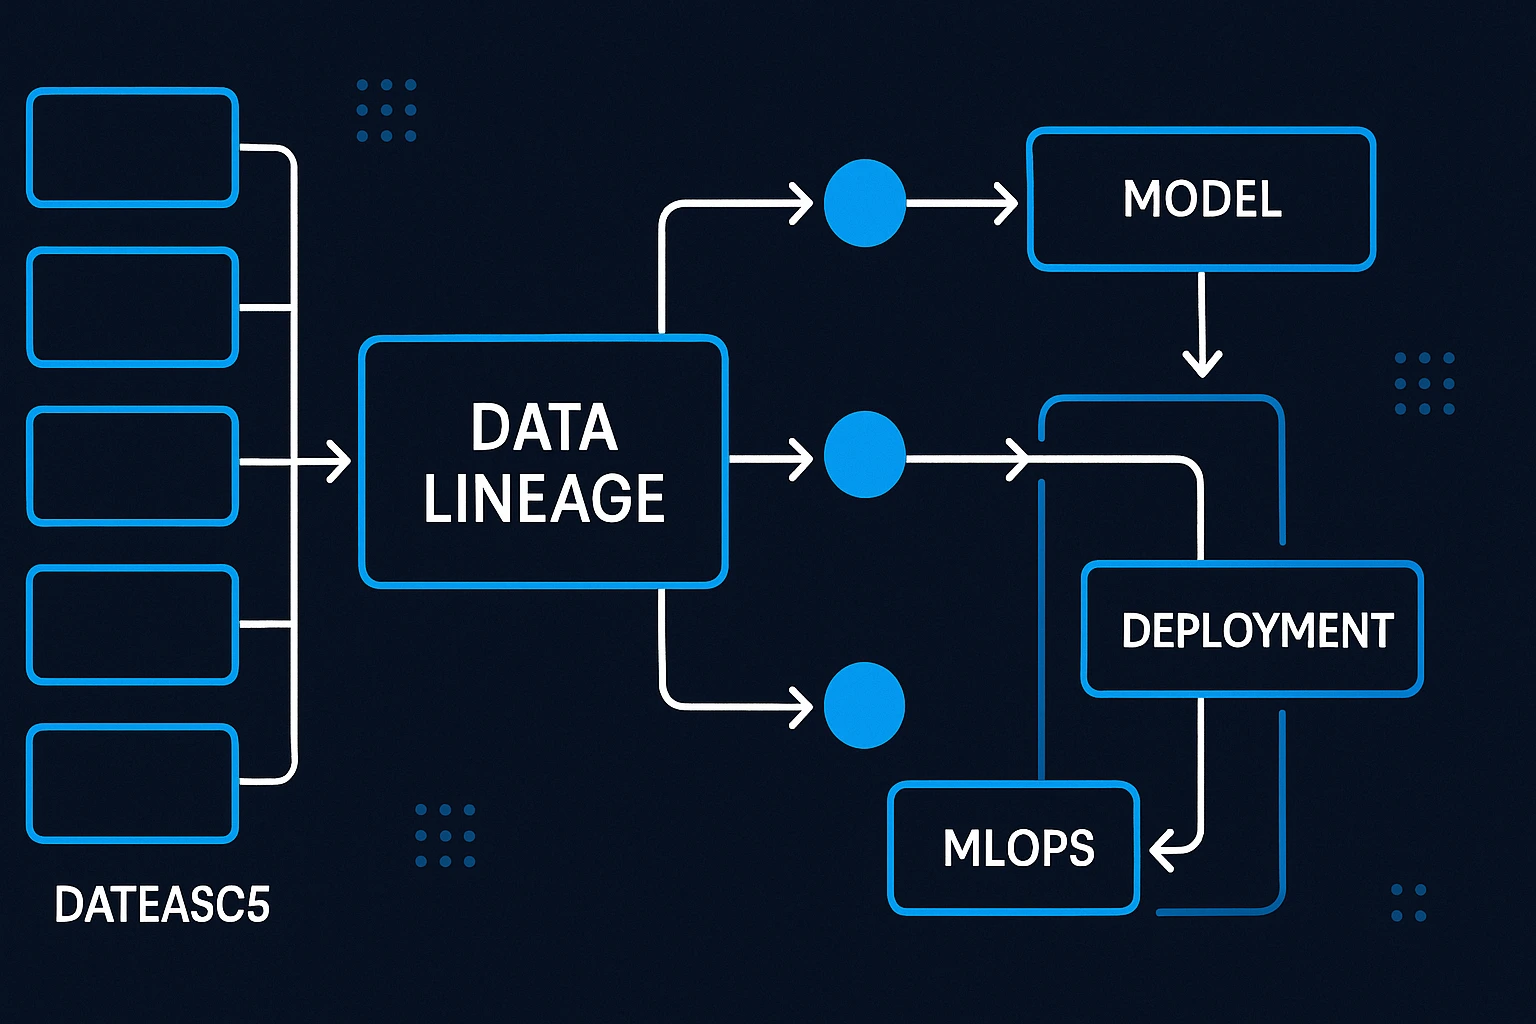
Les workflows modernes de ML comprennent souvent des pipelines de données en plusieurs étapes : ingestion, nettoyage, transformation, ingénierie de fonctionnalités, augmentation, stockage, entraînement du modèle, interprétation, surveillance et cycles de rétroaction. Chaque étape peut impliquer plusieurs systèmes et transformations. Le traçage des données capture cette totalité du processus, ce qui, à l’échelle, signifie un déluge de métadonnées. neptune.ai+2Actian+2
Ce suivi complet permet de garantir la traçabilité et l’obligation de rendre des comptes. Les équipes peuvent répondre à des questions telles que : d’où proviennent ces données, quelles transformations ont-elles subi et comment ont-elles été générées ? Cela est essentiel pour le dépannage, la conformité et la gouvernance.
Lorsque la latence devient une constante
Mais enregistrer chaque transformation peut devenir un frein. L’enregistrement constant de métadonnées peut ralentir l’ingestion ou les processus de transformation. Le stockage de versions redondantes de données, le suivi de chaque modification mineure ou l’enregistrement de grands ensembles de données peuvent consommer de la mémoire et des ressources informatiques. Dans des environnements très dynamiques, où les données arrivent en continu et où les modèles doivent être retravaillés rapidement, cette surcharge peut nuire à la performance, ralentir les pipelines et augmenter les coûts.
- Latence lors de l'enregistrement synchrone des métadonnées
- L'augmentation de la taille des données stockées dans les ensembles de données versionnés
- Réplication de données transformées
- Des retards dans l'exécution des projets pipeline en raison des frais de suivi
Une sur-instrumentalisation risque de compromettre l’objectif : la ligne de succession devient tellement lourde qu’elle nuit à l’agilité plutôt que de la favoriser.
Systèmes de gestion de la version : nécessaires ou juste un autre silo ?
Le contrôle des versions comme meilleure pratique MLOps
Outre le suivi du flux de données, le contrôle des versions pour les données, les modèles et le code est fondamental pour une MLOps robuste. Le contrôle des versions permet la reproductibilité, la collaboration et la traçabilité entre les expériences et les déploiements. lakeFS+2Wikipedia+2
Des outils tels que DVC permettent aux data scientists et aux ingénieurs d’utiliser des workflows similaires à Git pour les fichiers de données et de modèle, indépendants des référentiels de code, permettant ainsi des snapshots, des rollbacks et le suivi des expériences. Wikipedia + 1
Les risques de fragmentation dans le code, les données et les modèles
| Type d'objet | L'outil de contrôle des versions idéal | Risque de fragmentation |
| Code | Git | Baixo |
| Données | DVC, LakeFS | Moyen |
| Modèles | MLflow, poids et biais | Haute intensité sans intégration |
DevOps vs DataOps vs MLOps : qui possède quoi ?
Confusion de rôles dans les différentes disciplines de l'ingénierie
L’essor de la MLOps a brouillé les frontières entre l’ingénierie logicielle traditionnelle (DevOps), l’ingénierie des données (DataOps) et les opérations ML. Chaque discipline possède ses propres outils, processus et attentes en matière de responsabilité. Wikipedia+2VE3+2
Le DevOps se concentre sur le code, la CI/CD, les déploiements ; le DataOps s’occupe de l’ingestion de données, de la qualité des pipelines, du nettoyage et de la gouvernance ; le MLOOps relie les données, les modèles, le déploiement, le monitoring et la gestion du cycle de vie. Lorsqu’on introduit le concept de lineage, qui est responsable ? Le suivi des métadonnées ? La provenance des données ? La documentation de la gouvernance ?
Sans une propriété claire, la traçabilité des données devient une charge politique et opérationnelle plutôt qu'un atout stratégique.
Centraliser la propriété pour réduire les frais généraux
Inversement, lorsque les organisations adoptent un modèle unifié et interfonctionnel, avec une propriété partagée entre DevOps, DataOps et MLOps, la traçabilité devient un atout plutôt qu’un inconvénient. Les équipes collaborent sur la gouvernance des données, la conception des pipelines et le déploiement des modèles dans une unité cohérente. Cette intégration réduit les doubles emplois, évite les silos et garantit que la traçabilité des données et le contrôle des versions apportent une réelle valeur ajoutée.
Dans de telles configurations, les outils de hiérarchisation et le contrôle des versions s’intègrent parfaitement au flux de travail ; ils ne ressemblent pas à des “ fonctionnalités supplémentaires ”, mais à une infrastructure essentielle.
Overlap des équipes dans les écosystèmes MLOps
Gouvernance de l'IA et MLOps : un mariage de la conformité et du chaos ?
L’impératif de conformité en matière de traçabilité des données
Les organisations sont de plus en plus confrontées à des exigences réglementaires, éthiques et de conformité concernant l’IA et l’utilisation des données. Les organes de gouvernance exigent une transparence quant à l’origine des données, à la manière dont elles sont traitées et à la manière dont les modèles prennent leurs décisions. La traçabilité des données transforme les flux de données en preuves vérifiables, traçables et défendables. ibm.com+2databahn.ai+2
Dans les secteurs réglementés tels que la finance, les soins de santé et le secteur public, le défaut de fournir une source de données peut être catastrophique : violations de la conformité, dommages à la réputation et exposition juridique. Pour eux, la source de données n’est pas facultative ; elle est fondamentale pour une mise en œuvre responsable de l’IA.
Le prix opérationnel de la conformité aux normes de gouvernance
- La nécessité de disposer de référentiels de métadonnées centralisés
- Application de contrôles d’accès et enregistrement des audits
- Complience continue à la politique dans tous les environnements
- Investissements dans le DevSecOps orienté sur la conformité
MLOps doit choisir la transparence à chaque fois plutôt que la simplicité
Le débat entre transparence et complexité dans le MLOps n’est pas théorique. Alors que les systèmes d’apprentissage automatique prennent des décisions dans le monde réel – affectant le financement, la santé, la sécurité –, le coût de l’opacité devient insupportable. Les outils de traçabilité des données ne sont pas une charge bureaucratique : ils constituent une infrastructure essentielle pour la confiance, la responsabilité et la conformité.
Oui, l’ajout de la filiation introduit une complexité : gestion des métadonnées, poids de l’infrastructure, pipelines plus lents, surcoût de la procédure. Mais ces coûts sont minimes par rapport aux dangers cachés des flux de données non traçables : modèles irréprochables, résultats inexpliqués, exposition réglementaire et détérioration de la confiance des parties prenantes.
Les entreprises qui adoptent l’MLOps doivent considérer la traçabilité des données comme une nécessité fondamentale, et non comme une option. Le fardeau de la complexité est le prix de la fiabilité à long terme. Investir dans la traçabilité et le contrôle des versions n’empêche pas l’innovation, mais il protège la crédibilité des entreprises basées sur l’IA.
Références
- Pourquoi la traçabilité des données est importante pour la gouvernance – IBM
- Comprendre le parcours des données pour l’apprentissage automatique – Neptune.ai
- Comment la mise en place de la cloud façonne le MLOps – AWS
- Gestion du risque de modèle et conformité avec la traçabilité des données – Collibra
- Explication de l'architecture MLOps – LakeFS
- Décodage du triangle MLOps-DevOps-DataOps – Dataiku
- MLOps et le sens humain : activer l’IA ou ralentir son développement ?