Tabla de contenidos
- ¿Qué es la información sintética para dimensionar el mercado?
- ¿Por qué los datos sintéticos para dimensionar el mercado son importantes para las empresas en 2026?
- Cómo calcular TAM/SAM/SOM utilizando datos sintéticos: paso a paso
- Mejores prácticas para la dimensionamiento de datos del mercado sintético
- Cómo la IA está cambiando los datos sintéticos para dimensionar el mercado en 2026
- Herramientas y recursos para dimensionar el mercado sintético
- Conclusión
- Preguntas frecuentes
Las estimaciones de dimensionamiento del mercado solían tardar ocho semanas, pero $75,000 ahora se completan en tres días para menos de $10.000 unidades. Esta transformación se debe a la capacidad de los datos sintéticos para generar poblaciones de encuestados válidas estadísticamente sin reclutar a un solo participante real de la encuesta. Los cálculos tradicionales de TAM/SAM/SOM requieren una investigación primaria exhaustiva, plazos de campo prolongados y presupuestos considerables, lo que retrasa las decisiones críticas de entrada al mercado. Los datos sintéticos cambian esta ecuación al generar muestras representativas del mercado mediante métodos de generación impulsados por la inteligencia artificial que reflejan las características reales de la población. Los conjuntos de datos sintéticos bien construidos ofrecen estimaciones de dimensionamiento aplicables con una precisión comparable a los métodos tradicionales. En esta guía, descubrirá la metodología exacta para generar datos de mercado sintéticos, los procedimientos de cálculo de TAM/SAM/SOM paso a paso, las técnicas de validación que garantizan la fiabilidad y las herramientas de inteligencia artificial que transformarán la investigación de mercado en 2026.
¿Qué es la información sintética para dimensionar el mercado?
Los datos sintéticos para dimensionar el mercado son información generada artificialmente a nivel de los encuestados que replica las propiedades estadísticas, las distribuciones demográficas y los patrones de comportamiento de las poblaciones de clientes objetivo, lo que permite realizar cálculos rápidos del mercado total potencial (TAM), del mercado potencial disponible para servicios (SAM) y del mercado disponible para servicios (SOM) sin necesidad de realizar un trabajo de campo inicial. A diferencia de los datos de encuestas reales recopilados de los propios encuestados, los conjuntos de datos sintéticos se generan mediante modelado estadístico, algoritmos de IA generativa o enfoques híbridos que aprenden a partir de la inteligencia de mercado y fuentes demográficas existentes.
La metodología funciona mediante la formación de modelos generativos a partir de datos de referencia (estadísticas censales, puntos de referencia de la industria, bases de datos de clientes existentes) y luego la producción de miles de encuestados sintéticos que exhiben combinaciones realistas de datos demográficos, preferencias y comportamientos de compra. Cada encuestado sintético representa a un individuo plausible con características internas coherentes: la edad, la renta, la ubicación, el uso de la categoría, la disposición a pagar y la intención de compra se alinean de acuerdo con las correlaciones aprendidas a partir de los datos de entrenamiento.
Este enfoque resulta particularmente valioso al entrar en nuevos mercados, lanzar productos innovadores sin precedentes comparables o probar varios escenarios de mercado antes de asignar presupuestos de investigación. Una empresa de electrónica de consumo que dimensiona el mercado de un nuevo dispositivo wearable puede generar 10.000 consumidores sintéticos en diferentes grupos de edad, clases de ingresos y perfiles de adopción tecnológica en horas, en lugar de las semanas necesarias para reclutar y entrevistar a encuestados reales. La población sintética permite una análisis de segmentación inmediato, modelado de sensibilidad a los precios y evaluación de preferencias de canales, lo que permite informar los marcos de TAM/SAM/SOM con una precisión basada en datos.
¿Por qué los datos sintéticos para dimensionar el mercado son importantes para las empresas en 2026?
La velocidad dicta la ventaja competitiva en las decisiones de entrada al mercado. Las organizaciones que completan la dimensionamiento del mercado en días en lugar de en trimestres avanzan más rápidamente en lanzamientos de productos, decisiones de inversión y giros estratégicos. Según un estudio de Análisis de McKinsey, Las empresas que aceleran el tiempo de obtención de información en la investigación de mercado logran un crecimiento de ingresos 23% superior a las empresas del sector que se basan exclusivamente en los plazos tradicionales de investigación.
Las metodologías tradicionales de dimensionamiento de mercados imponen tres limitaciones críticas que los datos sintéticos eliminan. En primer lugar, la recolección de muestras para categorías nicho o emergentes a menudo resulta infructuosa porque no existen suficientes encuestados cualificados en las bases de datos de los proveedores de paneles. Una startup que apunta a los primeros adoptadores de soluciones de ciberseguridad resistentes a la computación cuántica no puede encontrar 500 encargados de decisiones informáticas cualificados en paneles estándar, pero la generación sintética puede modelar esta misma población basándose en patrones de adopción de tecnología cercanos y datos firmográficos.
En segundo lugar, los límites presupuestarios obligan a tomar decisiones binarias: o invertir en una investigación primaria exhaustiva o proceder con suposiciones informadas basadas en analogías y fuentes secundarias. Los datos sintéticos ofrecen una tercera opción: estimaciones rigurosas y basadas en datos, a una fracción de los costos tradicionales. Una empresa SaaS de Serie A con $30.000 asignados a la validación del mercado puede ahora generar múltiples escenarios de mercado, probar diferentes enfoques de segmentación y validar las hipótesis de demanda antes de comprometerse con costosas encuestas de paneles.
En tercer lugar, la dinámica del mercado cambia más rápidamente que los ciclos de investigación. Un estudio de dimensionamiento tradicional, realizado en enero, arroja resultados en marzo o abril, cuando las acciones competitivas, los cambios regulatorios o los cambios económicos podrían haber invalidado los hallazgos. Los enfoques sintéticos permiten la modelización continua del mercado, lo que permite a los equipos actualizar las estimaciones semanal o mensualmente a medida que se disponen nuevas informaciones. Esta capacidad iterativa transforma el dimensionamiento del mercado de una verificación única en una función de inteligencia estratégica continua.
El riesgo de proceder sin una evaluación válida del mercado sigue siendo considerable. Sobrarcar los mercados direccionables conduce a sobrefinanciación de los equipos de ventas, sobreconstrucción de la capacidad productiva y a prometer demasiado a los inversores. Sobrarcar los mercados resulta en oportunidades perdidas, esfuerzos de go-to-market insuficientes y salidas estratégicas de categorías viables. Los datos sintéticos reducen ambos modos de error al permitir la realización de pruebas rápidas de hipótesis antes de comprometerse de forma definitiva.
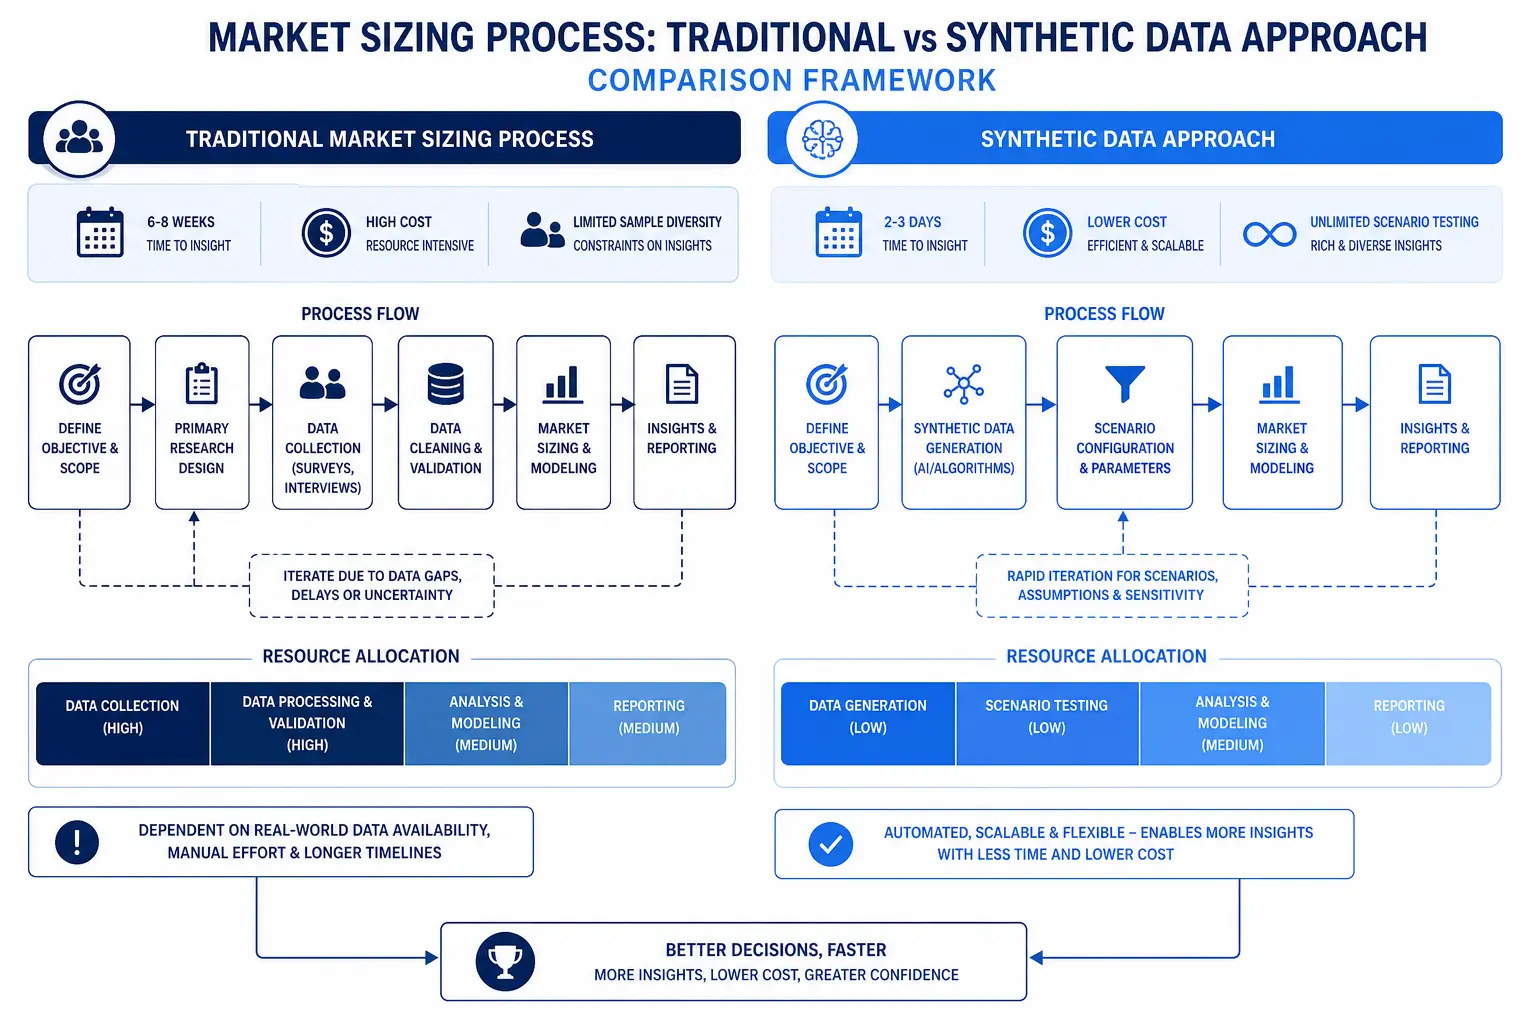
Cómo calcular TAM/SAM/SOM utilizando datos sintéticos: paso a paso
Paso 1: Defina los parámetros del mercado objetivo y los criterios de segmentación. Especifica el alcance geográfico (global, regional, nacional), los límites demográficos (intervalos de edad, umbrales de ingresos, tamaños de empresas) y las cualificaciones conductuales (usuarios de la categoría actual, propietarios de productos cercanos, personas que sufren de problemas específicos) que definen tu universo de destinatarios. Documenta explícitamente estos criterios porque regirán la generación de datos sintéticos. Para una herramienta de software B2B dirigida a empresas manufactureras de mercado medio, los parámetros podrían incluir: fabricantes con sede en Estados Unidos, entre 100 y 2.500 empleados, ingresos anuales entre $10 y $500 millones, que actualmente utilizan sistemas ERP heredados.
Etapa 2: Identificar y adquirir fuentes de datos de referencia para la síntesis. Recopile bases de datos estadísticos que informen sobre la generación sintética: distribuciones demográficas del censo, informes de asociaciones industriales sobre la penetración de las categorías, datos económicos gubernamentales sobre la población empresarial y cualquier dato de clientes confidencial proveniente de programas piloto o productos relacionados. La calidad y relevancia de los datos de referencia determinan directamente la validez de la producción sintética. Combine múltiples fuentes para crear un conjunto de datos de entrenamiento completo para los mercados de consumo, integre los microdatos del censo, encuestas sobre los gastos de los consumidores y estudios de compra específicos de cada categoría.
Paso 3: Generar una población de encuestados sintética utilizando una metodología adecuada. Aplique técnicas de síntesis estadística (imputación múltiple, modelado copula) o enfoques de IA generativa (encoders autoestratégicos variacionales, redes adversas generativas) para crear registros sintéticos a nivel individual. Cada registro debería incluir todas las variables necesarias para dimensionar el mercado: datos demográficos o de perfil de la empresa, conciencia de la categoría, soluciones actuales utilizadas, necesidades no satisfechas, intención de compra, disponibilidad de presupuesto y autoridad para tomar decisiones. Generar tamaños de muestra de 5.000 a 10.000 para los mercados nacionales, de 20.000+ para un análisis de segmentación detallado. Asegurar que la población sintética coincida con las distribuciones conocidas en variables clave si los datos del censo indican que 18% de la población objetivo de su grupo de edad vive en el noreste; su muestra sintética debería reflejar esa proporción.
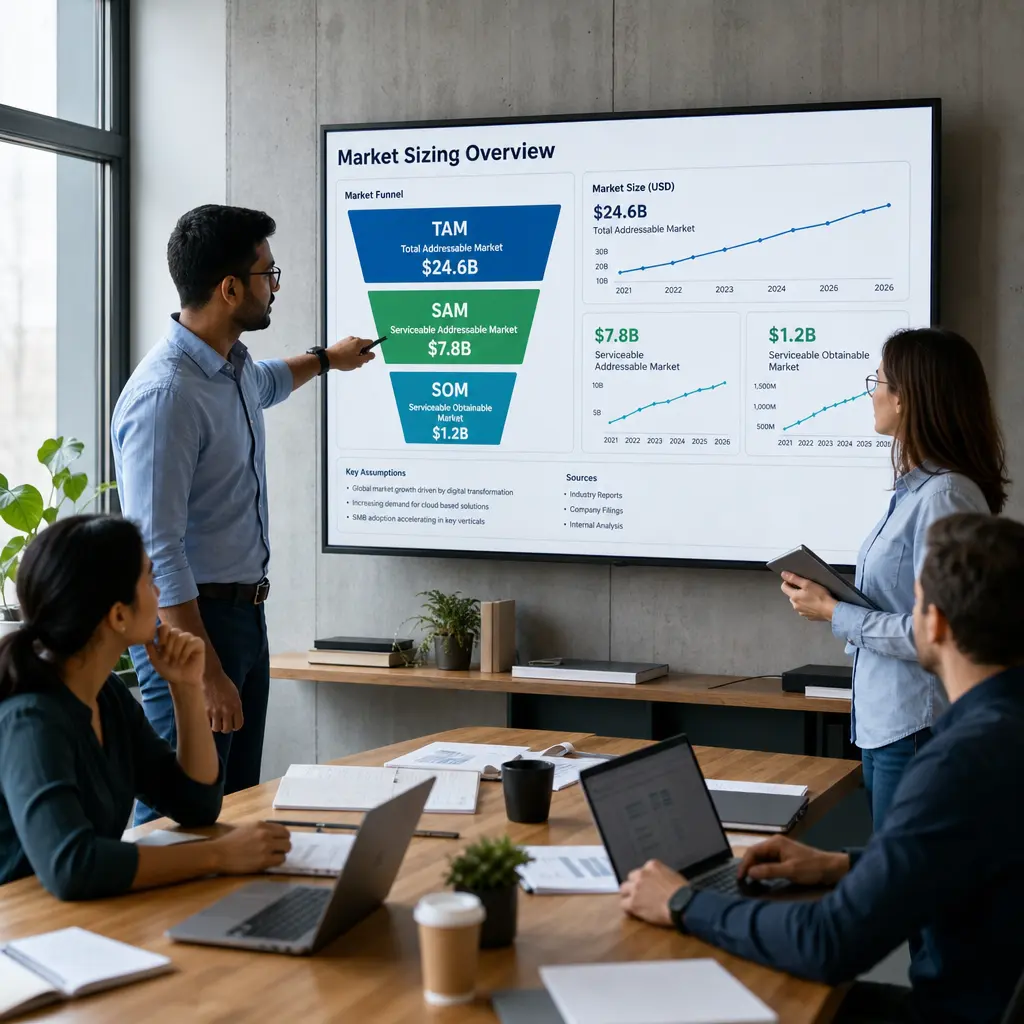
Pas 4: Calcular el Mercado Total Aceptable (TAM) a partir de la población sintética. TAM representa la oportunidad de ingresos total si logras un 100% de participación de mercado entre todos los compradores calificados. Contabiliza los encuestados sintéticos que cumplen tus criterios mínimos de elegibilidad, aplica una ponderación apropiada al proyecto a toda la población y luego multiplica por la media de ingresos por cliente. Para un producto SaaS mensual de $199 que apunta a 847.000 empresas estadounidenses calificadas (proyectado a partir de tus 8.470 empresas sintéticas que cumplen todos los criterios en una muestra de 1%), TAM es igual a 847.000 × $199 × 12 meses = $2.020 millones en ingresos recurrentes anuales.
Paso 5: Determinar el Mercado Aceptable de Servicios (SAM) mediante restricciones realistas. SAM reduce TAM aplicando limitaciones prácticas: alcance geográfico, acceso a canales, restricciones regulatorias o enfoque en segmentos. Filtre su población sintética para incluir únicamente a los encuestados a los que puede llegar de manera realista teniendo en cuenta las capacidades actuales. Si su modelo de ventas solo llega a empresas con relaciones existentes con sus socios de distribución, marque como sintéticos a los encuestados que correspondan a ese criterio. Si la conformidad normativa limita su alcance a ciertos estados, excluya los encuestados sintéticos que no correspondan a esas geografías. El TAM suele oscilar entre el 20-60% de la población, dependiendo de la madurez del modelo de negocio.
Paso 6: Estimación del mercado disponible para servicios (SOM) mediante la modelización de la adopción. SOM representa la parte de SAM que es realista capturar teniendo en cuenta la competencia, la notoriedad de la marca, la capacidad de ventas y el momento de entrada en el mercado. Analice las características sintéticas de los encuestados que indican una mayor probabilidad de conversión: puntos fuertes de dolor, insatisfacción con las soluciones actuales, disponibilidad de presupuesto, perfiles de adoptantes tempranos. Aplique supuestos de tasa de conversión calibrados en función de lanzamientos similares de productos o resultados de programas piloto. Una SOM realista en el primer año suele captar entre 2 y 8% de SAM para los nuevos participantes, escalando hasta 15-25% para los productos exitosos en el tercer año.
Pas 7: Validar las estimaciones sintéticas con los parámetros externos. Compruebe la coherencia de sus cálculos de TAM/SAM/SOM con informes de analistas del sector, ingresos comparables de empresas, divulgaciones financieras públicas y entrevistas con expertos. Si sus datos sintéticos indican un TAM de $2.000 millones pero los tres competidores establecidos del sector generan colectivamente $400 millones en ingresos, investigue la discrepancia; es posible que su definición de mercado sea demasiado amplia, que las tasas de adopción sean inferiores a las previstas o que exista una importante oportunidad de crecimiento. La validación no requiere una alineación perfecta, pero debería proporcionar explicaciones defensables para cualquier diferencia significativa.
Pas 8: Documente las hipótesis y cree modelos de escenarios. La transparencia sobre la metodología construye credibilidad entre los interesados y permite discusiones productivas sobre el potencial del mercado. Documento que describe los datos de referencia que informaron la síntesis, qué criterios de calificación definieron cada nivel de mercado, qué supuestos impulsaron las tasas de adopción y dónde el juicio experto complementó los datos. Se elaboran escenarios alternativos que ponen a prueba diferentes supuestos: optimistas (adopción más alta, crecimiento más rápido), base de referencia (supuestos moderados) y conservadores (adopción más lenta, mayor competencia). El bajo costo marginal de los datos sintéticos hace que el análisis de escenarios sea práctico y genere poblaciones sintéticas adicionales que reflejen diferentes condiciones de mercado o comportamientos de los clientes.
Mejores prácticas para la dimensionamiento de datos del mercado sintético
1. Priorizar la precisión demográfica en detrimento de la complejidad conductual en la síntesis inicial. Las poblaciones sintéticas deben coincidir con las distribuciones demográficas conocidas con una alta fidelidad antes de incorporar variables comportamentales. Verifique que las distribuciones de edad, ingresos, geografía, educación y características de la empresa se alineen con los datos del censo o de la industria dentro de un margen de 2-3 puntos porcentuales. Luego, las variables comportamentales (intención de compra, preferencias de marca, disposición a pagar) pueden modelarse condicionalmente sobre estas bases demográficas, garantizando la coherencia interna.
2. Generar múltiples muestras sintéticas independientes para evaluar la estabilidad. Cree tres poblaciones sintéticas separadas utilizando la misma metodología y datos de referencia. Calcule el TAM/SAM/SOM para cada una de ellas de forma independiente. Si las estimaciones varían en más del 15-20%, investigue qué variables determinan la varianza y si son necesarias restricciones adicionales o tamaños de muestra más grandes. Resultados consistentes en muestras independientes indican una metodología robusta; una alta varianza indica que su proceso de generación no ha captado adecuadamente la estructura de la población.
3. Incorpore puntos de verificación de validación en toda la población sintética. Incluya pruebas de respuesta conocida en sus datos sintéticos para verificar la coherencia lógica. Si un encuestado sintético afirma ser un director financiero de 28 años de una empresa de 2.000 empleados, marque esta información como poco probable. Los directores financieros de ese tamaño suelen tener más de 15 años de experiencia. Cree reglas de validación que comprueben combinaciones imposibles, inconsistencias lógicas y valores estadísticos que nunca aparecerían en poblaciones reales. Limpie o regene los registros que no cumplan estas comprobaciones.
4. Datos sintéticos para corregir los sesgos conocidos en las fuentes de referencia. Si los datos de entrenamiento sobreestiman ciertos segmentos o subestiman otros, aplique pesos de post-stratificación para alinear la salida sintética con los parámetros de la población objetivo. Los paneles de consumidores a menudo subestiman a las familias de bajos ingresos y a las muy altas; los datos del censo proporcionan la distribución correcta para reestimar los pesos. Las bases de datos B2B tienden a centrarse en empresas más grandes y visibles; los registros comerciales gubernamentales ofrecen distribuciones de tamaño más completas para la calibración.
5. Testar la sensibilidad a los precios mediante experimentos de elección conjunta o discreta. En lugar de preguntar a encuestados sintéticos una única pregunta sobre la disposición a pagar, modelen sus decisiones en función de múltiples configuraciones de producto, puntos de precio y alternativas competitivas. Este enfoque produce curvas de demanda y estimaciones de ingresos más realistas, ya que captura decisiones de compensación en lugar de intenciones declaradas. Un encuestado sintético que afirma que pagaría $299/mes podría optar por la oferta de un competidor con $199 características cuando se le presenten comparaciones reales de prestaciones.
6. Contrariamente a lo que podría parecer, muestras sintéticas más pequeñas con un mayor rigor de validación dan mejores resultados que muestras más grandes con una validación débil. Una población sintética de 5.000 registros que haya sido validada exhaustivamente en función de múltiples parámetros de referencia, haya sido probada en cuanto a la coherencia lógica y haya sido ponderada para ajustarse a las distribuciones conocidas producirá un dimensionamiento del mercado más confiable que una población de 50.000 registros generada sin validación. La calidad de la síntesis es más importante que la cantidad de registros. Se debe concentrar los esfuerzos en los procedimientos de validación en lugar de maximizar simplemente el tamaño de la muestra.
7. Documente la procedencia de cada variable en su conjunto de datos sintético. Mantener un diccionario de datos que remita cada campo a su fuente: datos censales, modelados a partir de datos de clientes, imputados a partir de parámetros de referencia de la industria o generados a través de relaciones estadísticas. Esta transparencia permite a los interesados evaluar qué estimaciones se basan en sólidos fundamentos empíricos y qué dependen de supuestos de modelado. También facilita las actualizaciones cuando se disponga de datos de referencia más fiables.
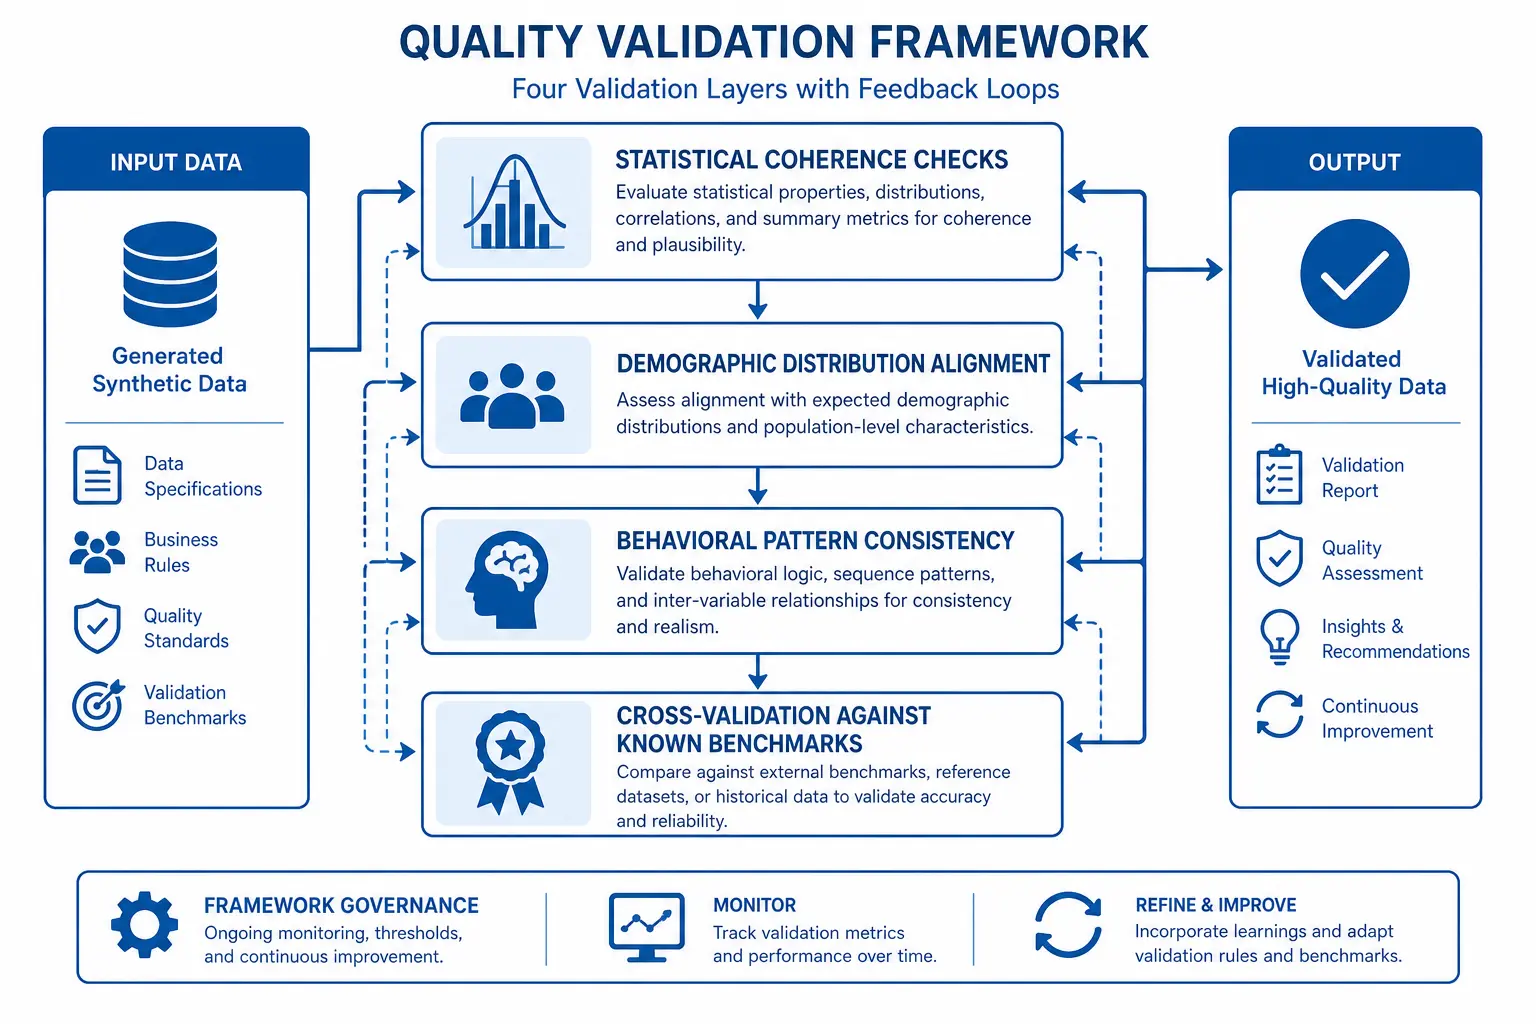
Cómo la IA está cambiando los datos sintéticos para dimensionar el mercado en 2026
Los grandes modelos de lenguaje ahora generan respuestas sintéticas a encuestas que captan el razonamiento de los clientes de manera más detallada, en lugar de simplemente mostrar datos demográficos y puntuaciones de intención de compra. Cuando un respondiente sintético indica que no compraría un producto, los sistemas impulsados por LLM pueden generar explicaciones plausibles basadas en el perfil demográfico del respondiente, el uso actual de la solución y los puntos de dolor. Esta riqueza cualitativa permite a los equipos de dimensionamiento del mercado comprender no solo cuántos clientes potenciales existen, sino también por qué ciertos segmentos muestran una propensión más alta o más baja a adoptar la solución.
Los sistemas de IA multimodales integran diversas fuentes de datos: bases de datos demográficas, señales de redes sociales, indicadores económicos y inteligencia competitiva, para crear poblaciones sintéticas con un realismo sin precedentes. En lugar de construir conjuntos de datos sintéticos a partir de una única fuente de referencia, el enfoque de 2026 combina múltiples flujos de información para crear encuestados sintéticos cuyas características reflejan las complejas correlaciones del mundo real. Los patrones de adopción de tecnología de un pequeño propietario de empresa se correlacionan adecuadamente con su vertiente industrial, la trayectoria de crecimiento de la empresa y las condiciones económicas regionales, ya que el proceso de síntesis de IA aprendió estas relaciones a partir de datos integrados.
Los sistemas de aprendizaje continuo actualizan automáticamente las poblaciones sintéticas a medida que lleguen nuevas informaciones del mercado. La metodología tradicional de dimensionamiento del mercado se vuelve obsoleta en el momento en que concluye el trabajo de campo, pero los enfoques sintéticos impulsados por la inteligencia artificial pueden incorporar nuevos lanzamientos de competidores, cambios regulatorios o cambios económicos en las estimaciones del mercado actualizadas en cuestión de horas. Las organizaciones implementan marcos de dimensionamiento del mercado dinámicos en los que las poblaciones sintéticas evolucionan junto con las condiciones del mercado, proporcionando estimaciones siempre actualizadas de TAM/SAM/SOM que informan la planificación estratégica ágil.
La IA de inferencia causal distingue la correlación de la causalidad en la generación de datos sintéticos, produciendo previsiones de adopción más precisas. Los métodos de datos sintéticos anteriores simplemente replicaban los patrones estadísticos de los datos de entrenamiento, pero los modelos de IA causal comprenden qué variables impulsan las decisiones de compra y cuáles simplemente se correlacionan con ellas. Esta distinción es de enorme importancia para dimensionar el mercado, ya que saber que la adopción de productos se debe a problemas específicos en lugar de estar simplemente correlacionados con determinados demográficos permite estimar con mayor precisión la segmentación de mercado y la segmentación de mercado objetivo.
Las técnicas de IA explicables hacen que el dimensionamiento del mercado sintético sea transparente y verificable. Los interesados pueden preguntar por qué surgió una determinada estimación de TAM, qué supuestos influyeron más en el resultado y cómo las conclusiones son sensibles a diferentes opciones de modelado. Esta transparencia aumenta la confianza en los enfoques sintéticos entre los ejecutivos, los inversores y los miembros del consejo de administración que antes veían las estimaciones generadas por la IA con escepticismo. La caja negra se convierte en una caja de vidrio, con una visibilidad clara desde los datos de referencia hasta la metodología de síntesis hasta los resultados finales de dimensionamiento del mercado.
Herramientas y recursos para dimensionar el mercado sintético
Gretel.ai proporciona una plataforma de datos sintéticos diseñada específicamente para conjuntos de datos tabulares comunes en la investigación de mercado. El servicio acepta archivos CSV que contienen datos de referencia y genera poblaciones sintéticas estadísticamente equivalentes, preservando las correlaciones entre las variables. Especialmente valioso para organizaciones con bases de datos de clientes propias que desean complementar los datos reales limitados con extensiones sintéticas para una dimensionamiento del mercado más robusto. El precio comienza en $500/mes para la generación de datos sintéticos de calidad de investigación.
Principalmente IA Ofrece la generación de datos sintéticos para empresas con fuertes garantías de privacidad y reportes de validación. La plataforma verifica automáticamente los resultados sintéticos contra las distribuciones de datos de referencia y alerta de anomalías estadísticas que podrían comprometer la precisión en el dimensionamiento del mercado. La privacidad diferencial incorporada garantiza que los datos sintéticos no puedan ser analizados para identificar personas reales, abordando las preocupaciones de cumplimiento cuando los datos de referencia incluyen información sobre clientes. Las licencias empresariales comienzan desde $2.000 al mes.
La biblioteca SDV (Synthetic Data Vault) de Python Provee herramientas de código abierto para generar datos tabulares, relacionales y de series temporales sintéticos. Los científicos de datos pueden implementar flujos de trabajo de síntesis personalizados adaptados a los requisitos específicos de dimensionamiento del mercado, aplicando técnicas avanzadas como las copulas gaussianas o el CTGAN (Conditional Tabular GAN), dependiendo de las características de los datos. Es gratuito y de código abierto y requiere experiencia en programación Python pero ofrece máxima flexibilidad.
Muestra de datos microdatos de uso público del Censo (PUMS) Sirve como datos de referencia de alta calidad para dimensionar el mercado de consumo de los Estados Unidos. Estos registros censales individualizados y anonimizados proporcionan características demográficas, económicas y habitacionales a millones de encuestados, ofreciendo una base empírica para la generación sintética de la población. El acceso es gratuito a través del portal de datos del Censo, aunque el procesamiento de archivos PUMS grandes requiere software estadístico y capacidades de ingeniería de datos.
Statista y IBISWorld Proporcionan datos de mercado específicos para la industria que calibran y validan las estimaciones sintéticas. Aunque no son generadores de datos sintéticos en sí mismos, estas plataformas proporcionan los puntos de referencia externos necesarios para verificar que los cálculos de TAM/SAM/SOM sintéticos se ajusten a la inteligencia de mercado establecida. Las suscripciones varían entre $1.200 y $5.000 al año, dependiendo de la cobertura de la industria y el acceso de los usuarios.
Herramientas de análisis conjuntivo de Qualtrics Integrado con la generación de encuestados sintéticos permite una sofisticada modelación de sensibilidad a los precios y de la compensación de características. Las organizaciones pueden probar docenas de configuraciones de producto y escenarios de precios en poblaciones sintéticas antes de comprometerse con costosas investigaciones conjuntas basadas en elecciones con encuestados reales. Las licencias Enterprise de Qualtrics con módulos de análisis avanzados comienzan alrededor de $10.000 al año.
Conclusión
Los datos sintéticos transforman el dimensionamiento del mercado de un proceso lento y costoso de verificación previa, convirtiéndolo en una función de inteligencia estratégica rápida e iterativa. Esta metodología proporciona estimaciones de TAM/SAM/SOM validadas en días, en lugar de meses, con costos 70-85% más bajos que la investigación primaria tradicional, al tiempo que permite una perfeccionamiento continuo a medida que evolucionan las condiciones del mercado. Las organizaciones que dominan estos enfoques sintéticos obtienen ventajas decisivas en el timing de la entrada en el mercado, la asignación de inversión y la precisión de la planificación estratégica. El marco paso a paso presentado aquí, desde la definición de parámetros objetivo hasta la validación contra puntos de referencia externos, proporciona un camino comprobado hacia estimaciones sintéticas de mercado fiables. Las mejores prácticas en materia de precisión demográfica, generación de muestras independientes y validación rigurosa garantizan que las estimaciones sintéticas cumplan con los estándares exigidos por los inversores y los ejecutivos. Los avances en IA en 2026 hacen que las poblaciones sintéticas sean más realistas, más transparentes y más dinámicamente adaptables a las cambiantes condiciones del mercado que nunca antes. Explora cómo H-in-Q.com puede ayudarte Su organización implementa marcos de datos sintéticos que aceleran la inteligencia de mercado manteniendo al mismo tiempo un alto nivel de rigor en la investigación. La ventaja competitiva pertenece a los equipos que dimensionan los mercados de forma más rápida y precisa que sus rivales. Los datos sintéticos hacen que ambos aspectos sean posibles simultáneamente.
Preguntas frecuentes
¿Qué precisión tiene la información sintética para los cálculos de TAM SAM SOM?
Los datos sintéticos alcanzan una precisión del 85-92% para el dimensionamiento del mercado cuando se validan adecuadamente en comparación con los parámetros de referencia del mundo real y las distribuciones demográficas. La precisión depende de la calidad de los datos de entrenamiento, de la metodología de generación y de la rigurosidad de la validación aplicada durante el proceso de síntesis.
¿Pueden los datos sintéticos reemplazar por completo la investigación de mercado tradicional?
Los datos sintéticos son más efectivos como herramienta para probar hipótesis rápidamente antes de comprometerse con una investigación primaria costosa. Son excelentes para dimensionar en etapas iniciales, modelar escenarios e identificar qué segmentos de clientes requieren una investigación más profunda mediante métodos tradicionales.
¿Qué tamaño de muestra de datos sintéticos necesito para obtener estimaciones de mercado fiables?
Generar un mínimo de 5.000 encuestados sintéticos para dimensionar el mercado nacional, y más de 10.000 para análisis segmentados en múltiples demografías. Muestras más grandes reducen la varianza en los segmentos de alto rendimiento y permiten análisis geográficos o psicográficos más detallados.
¿Cómo valido los datos de dimensionamiento del mercado sintético?
Compruebe la coherencia estadística en las distribuciones demográficas, la coherencia lógica en los patrones de comportamiento y la alineación con los parámetros de referencia del mercado antes de finalizar las estimaciones, realizando una comparación entre los resultados obtenidos mediante el análisis sintético y los datos del censo, los informes de la industria y los datos existentes de los clientes.
¿Cuál es el ahorro de costos típico al utilizar datos sintéticos para dimensionar el mercado?
Las organizaciones reportan una reducción de costos de entre un 70 y un 85% en comparación con la investigación primaria tradicional. Un estudio convencional de dimensionamiento del mercado que cuesta entre $50.000 y $100.000 puede ser reemplazado por enfoques sintéticos que cuestan entre $5.000 y $15.000, pero ofrecen resultados en días en lugar de meses.
¿Qué industrias se benefician más de los datos de dimensionamiento de mercado sintéticos?
Los productos de consumo de rápido movimiento, el SaaS, la fintech y la salud registran los mayores valores. Las industrias con ciclos de producto rápidos, frecuentes decisiones de entrada en el mercado o la necesidad de una supervisión continua del mercado obtienen una ventaja competitiva gracias a la velocidad y la flexibilidad de los datos sintéticos.