Table des matières
- Qu’est-ce que les données synthétiques pour la dimensionnement du marché ?
- Pourquoi les données synthétiques pour la dimensionnement du marché sont importantes pour les entreprises en 2026
- Comment calculer TAM/SAM/SOM à l’aide de données synthétiques : étape par étape
- Meilleures pratiques pour les données de dimensionnement du marché synthétique
- Comment l’IA transforme les données synthétiques pour la dimensionnement du marché en 2026
- Outils et ressources pour la dimensionnement du marché synthétique
- Conclusion
- Questions fréquemment posées
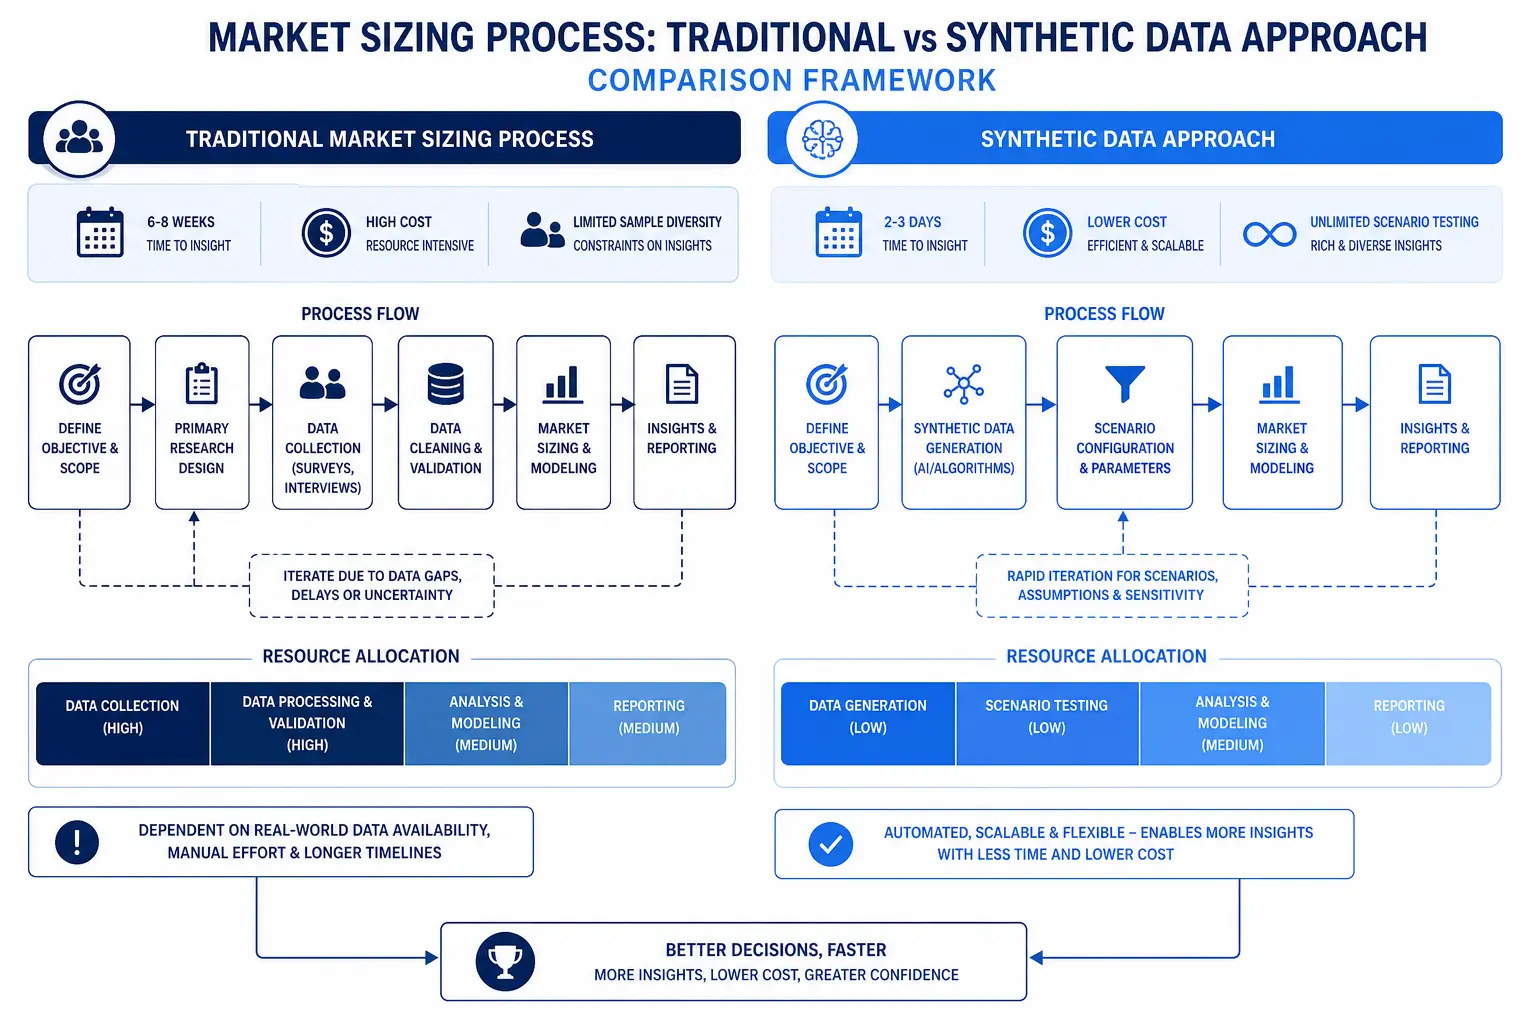
Les estimations concernant la taille du marché, auparavant longues de huit semaines, se déroulent $75,000 désormais en trois jours pour moins de $10 000 exemplaires. Cette transformation découle de la capacité des données synthétiques à générer des populations de répondants valables sur le plan statistique sans recruter un seul participant réel à une enquête. Les calculs traditionnels de TAM/SAM/SOM nécessitent une recherche primaire approfondie, des délais de terrain prolongés et des budgets importants, ce qui retarde les décisions critiques concernant le lancement sur le marché. Les données synthétiques modifient cette équation en produisant des échantillons représentatifs du marché grâce à des méthodes de génération basées sur l’IA qui reproduisent les caractéristiques réelles de la population. Des ensembles de données synthétiques correctement constitués fournissent des estimations de taille utilisables avec une précision comparable aux méthodes traditionnelles. Dans cette guide, vous découvrirez la méthodologie exacte pour générer des données de marché synthétiques, les procédures de calcul de TAM/SAM/SOM étape par étape, les techniques de validation qui garantissent la fiabilité et les outils d’IA transformant la recherche de marché en 2026.
Qu’est-ce que les données synthétiques pour la dimensionnement du marché ?
Les données synthétiques pour la dimensionnement du marché sont des informations générées artificiellement à l’échelle des répondants, qui reproduisent les propriétés statistiques, les distributions démographiques et les comportements des populations cibles de clients, permettant ainsi d’effectuer rapidement des calculs de marché total atteignable (TAM), de marché atteignable utilisable (SAM) et de marché atteignable utilisable (SOM) sans avoir à effectuer de travail de terrain. Contrairement aux données d’enquêtes réelles collectées auprès de répondants réels, les ensembles de données synthétiques sont créés grâce à la modélisation statistique, à des algorithmes d’intelligence artificielle générative ou à des approches hybrides qui s’appuient sur des informations existantes concernant le marché et des sources démographiques.
La méthodologie fonctionne en entraînant des modèles générationnels à partir de données de référence telles que les statistiques du recensement, les benchmarks de l’industrie, les bases de données existantes des clients ou des petits projets pilotes, puis en produisant des milliers de répondants synthétiques présentant des combinaisons réalistes de caractéristiques démographiques, de préférences et de comportements d’achat. Chaque répondant synthétique représente un individu plausible présentant des caractéristiques internes cohérentes : l’âge, le revenu, l’emplacement, l’utilisation des catégories, la volonté de payer et l’intention d’achat s’alignent selon des corrélations apprises à partir des données d’entraînement.
Cette approche s’avère particulièrement utile lors de l’entrée sur de nouveaux marchés, du lancement de produits innovants dépourvus de précédents comparables ou encore lors de l’évaluation de plusieurs scénarios de marché avant d’allouer des budgets de recherche. Une entreprise du secteur de l’électronique grand public pouvant estimer le marché d’un nouveau dispositif portatif peut générer 10 000 consommateurs fictifs répartis dans différentes tranches d’âge, groupes d’intérêts et profils d’adoption technologique en quelques heures, au lieu des semaines nécessaires pour recruter et sonder des répondants réels. Cette population fictive permet d’effectuer des analyses immédiates de segmentation, de modéliser la sensibilité aux prix et d’évaluer les préférences de canaux, ce qui permet d’élaborer des cadres de TAM/SAM/SOM fondés sur des données avec une précision basée sur les données.
Pourquoi les données synthétiques pour la dimensionnement du marché sont importantes pour les entreprises en 2026
La vitesse détermine l’avantage compétitif dans les décisions d’entrée sur le marché. Les organisations qui réalisent une analyse de marché en quelques jours plutôt que en quelques trimestres avancent plus rapidement dans la mise sur le marché de leurs produits, dans les décisions d’investissement et dans les changements stratégiques. Selon un Analyse de McKinsey, Les entreprises qui accélèrent le temps de mise en évidence des tendances sur le marché enregistrent une croissance des revenus supérieure de 23% par rapport aux concurrents qui s'appuient exclusivement sur des méthodologies de recherche traditionnelles.
Les méthodologies traditionnelles de dimensionnement des marchés imposent trois contraintes critiques que les données synthétiques éliminent. Premièrement, le recrutement d’échantillons pour les catégories spécifiques ou émergentes échoue souvent car il n’existe pas de répondants qualifiés dans les bases de données des fournisseurs de panels. Une start-up qui vise les premiers utilisateurs de solutions de cybersécurité résilientes aux attaques quantiques ne peut trouver 500 décideurs informatiques qualifiés dans des panels standard, mais la génération synthétique peut néanmoins modéliser cette population exacte en s’appuyant sur les schémas d’adoption des technologies voisines et sur des données concernant les entreprises.
Deuxièmement, les contraintes budgétaires imposent des choix binaristes : investir massivement dans une recherche primaire complète ou procéder à des estimations fondées sur des analogies et des sources secondaires. Les données synthétiques offrent une troisième option : des estimations rigoureuses et fondées sur des données, à un prix fractionnaire des coûts traditionnels. Une entreprise SaaS de Série A disposant de $30 000 ressources allouées à la validation du marché peut désormais générer plusieurs scénarios de marché, tester différents approches de segmentation et valider les hypothèses de demande avant de s’engager dans des enquêtes coûteuses auprès d’un panel de consommateurs.
Troisièmement, les dynamiques du marché évoluent plus rapidement que les cycles de recherche. Une étude de dimensionnement traditionnelle commandée en janvier délivre ses résultats en mars ou avril, date à laquelle des mouvements concurrentiels, des changements réglementaires ou des changements économiques pourraient avoir invalidé les conclusions. Les approches synthétiques permettent de modéliser le marché en permanence, permettant aux équipes de mettre à jour les estimations chaque semaine ou chaque mois dès qu’une nouvelle information devient disponible. Cette capacité répétitive transforme la dimensionnement du marché d’une étape de contrôle ponctuel en une fonction d’intelligence stratégique permanente.
Le risque de procéder sans une évaluation validée du marché reste considérable. Surévaluer les marchés cibles conduit à financer en excès les équipes commerciales, à construire en excès les capacités de production et à promettre trop aux investisseurs. Sous-évaluer les marchés entraîne des opportunités non saisies, des efforts insuffisants pour lancer le produit sur le marché et des sorties stratégiques de catégories viables. Les données synthétiques réduisent les deux modes d’erreur en permettant d’effectuer des tests d’hypothèses rapides avant des engagements définitifs.
Comment calculer TAM/SAM/SOM à l’aide de données synthétiques : étape par étape
Première étape : Définissez les paramètres de votre marché cible et les critères de segmentation. Définissez le champ géographique (mondial, régional, national), les limites démographiques (gammes d’âge, seuils de revenus, tailles d’entreprise) et les caractéristiques comportementales (utilisateurs de la catégorie actuelle, propriétaires de produits voisins, personnes souffrant de problèmes spécifiques) qui définissent votre public cible. Documentez ces critères de manière explicite car ils régiront la génération de données synthétiques. Pour un outil logiciel B2B ciblant des entreprises manufacturières de milieu de gamme, les paramètres pourraient inclure : des fabricants basés aux États-Unis, 100 à 2 500 employés, un chiffre d’affaires annuel de $10 à $500 millions, utilisant actuellement des systèmes ERP hérités.
Étape 2 : Identifier et acquérir des sources de données de référence pour la synthèse. Recueillir des bases de données statistiques qui serviront à alimenter la génération synthétique : données démographiques du recensement, rapports d’associations professionnelles sur la pénétration des catégories, données économiques gouvernementales sur la population des entreprises, ainsi que toutes les données clients propriétaires issues de programmes pilotes ou de produits connexes. La qualité et la pertinence des données de référence déterminent directement la validité des résultats synthétiques. Combiner plusieurs sources pour créer un ensemble de données de formation complet pour les marchés de consommation, intégrer les microdonnées du recensement, les enquêtes sur la consommation des consommateurs et les études de comportement d’achat spécifiques à chaque catégorie.
Étape 3 : Générer une population de répondants synthétique à l’aide d’une méthodologie appropriée. Utilisez des techniques de synthèse statistique (imputation multiple, modélisation copula) ou des approches d’IA générative (autoencodage variant, réseaux adverses génératifs) pour créer des enregistrements synthétiques à l’échelle individuelle. Chaque enregistrement devrait inclure toutes les variables nécessaires à l’évaluation du marché : caractéristiques commerciales ou démographiques, sensibilisation à la catégorie, solutions actuelles utilisées, besoins non satisfaits, intention d’achat, budget disponible et autorité décisionnelle. Générez des tailles d’échantillon de 5 000 à 10 000 pour les marchés nationaux, de 20 000+ pour une analyse de segmentation détaillée. Assurez que la population synthétique corresponde aux distributions connues pour les variables clés si les données du recensement indiquent que 18% de votre cohorte cible d’âge vit dans le Nord-Est ; votre échantillon synthétique devrait refléter cette proportion.
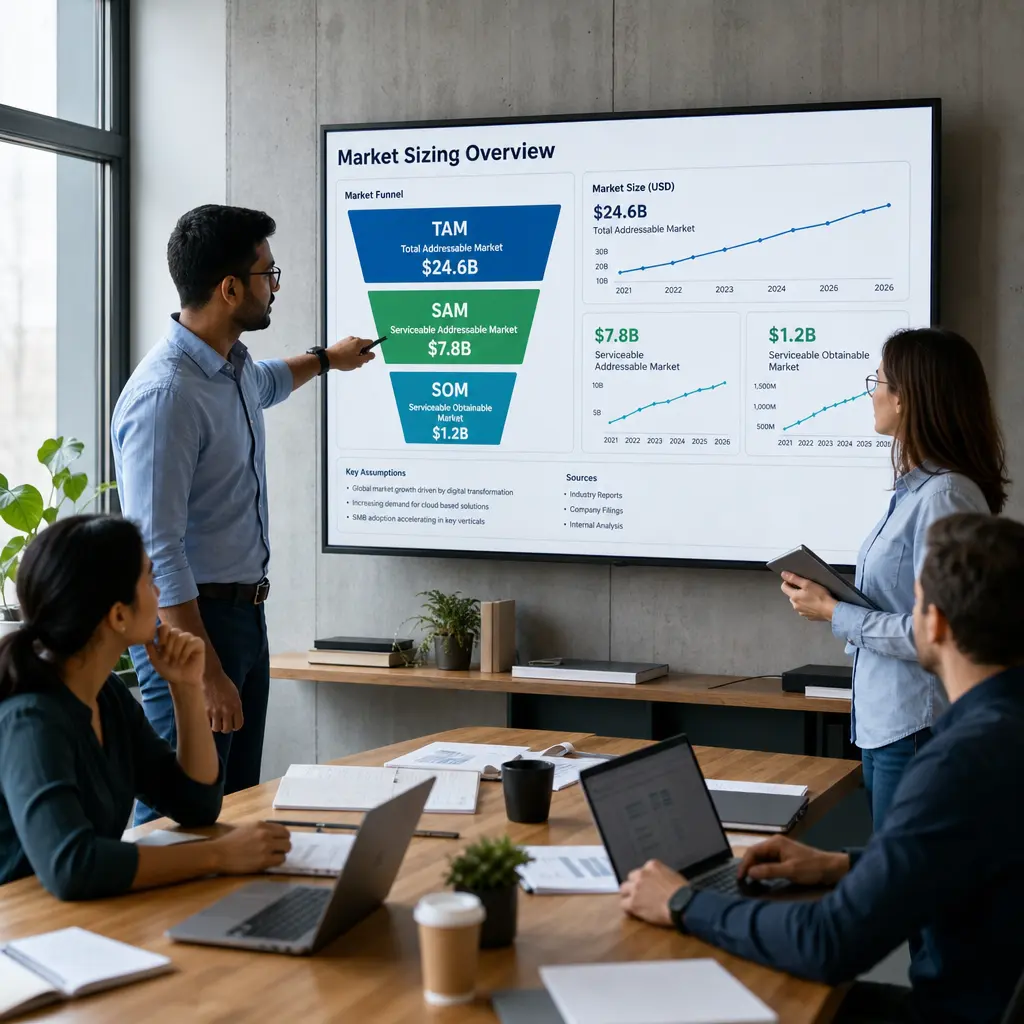
Étape 4 : Calculer le marché total atteignable (TAM) à partir de la population synthétique. TAM représente l’opportunité de revenus totale si vous atteigniez une part de marché de 100% parmi tous les acheteurs qualifiés. Comptabilisez les répondants synthétiques répondant à vos critères de qualification minimum, appliquez une pondération appropriée au projet à l’ensemble de la population, puis multipliez par le revenu moyen par client. Pour un produit SaaS mensuel de $199 visant 847 000 entreprises américaines qualifiées (estimé à partir de vos 8 470 sociétés synthétiques répondant à tous les critères d’un 1% échantillon), TAM équivaut à 847 000 x $199 x 12 mois = $2,02 milliards de revenus récurrents annuels.
Étape 5 : Définir le marché desservi par un adhésif serviceable (SAM) grâce à des contraintes réalistes. SAM réduit TAM en appliquant des limites pratiques : portée géographique, accès aux canaux, restrictions réglementaires ou focus sur un segment. Filtrez votre population synthétique uniquement sur les répondants que vous pouvez réellement servir compte tenu des capacités actuelles. Si votre modèle de vente ne concerne que les entreprises ayant des relations existantes avec vos partenaires de distribution, flagguez les répondants synthétiques correspondant à ce critère. Si la conformité réglementaire vous limite à certains États, excluez les répondants synthétiques en dehors de ces régions géographiques. SAM varie généralement entre 20 et 60% de TAM, en fonction de la maturité du modèle d’entreprise.
Étape 6 : Évaluer le marché disponible pour le service (SOM) en utilisant la modélisation de l'adoption. SOM représente la part de SAM que vous pouvez réellement capturer en fonction de la concurrence, de la notoriété de la marque, de la capacité de vente et du timing de l’entrée sur le marché. Analyser les caractéristiques des répondants synthétiques indiquant une plus forte probabilité de conversion : points d’inflexion forts, insatisfaction avec les solutions actuelles, disponibilité budgétaire, profil de personnes ayant adopté le produit très tôt. Utiliser des hypothèses de taux de conversion calibrées sur des lancements similaires de produits ou des résultats de programmes pilotes. Une SOM réaliste pour l’année 1 capture souvent entre 2 et 8% de SAM pour les nouveaux entrants, montant jusqu’à 15 à 25% d’ici l’année 3 pour les produits réussis.
Étape 7 : Vérifier les estimations synthétiques par rapport aux critères externes. Comparez vos calculs de TAM/SAM/SOM avec les rapports d’analystes de l’industrie, les revenus comparables des entreprises, les informations financières publiques et les entretiens avec des experts. Si vos données synthétiques indiquent un TAM de $2 milliards, mais que les trois principaux concurrents du secteur génèrent collectivement $400 millions de revenus, examinez la divergence : soit votre définition du marché est trop large, les taux d’adoption sont inférieurs aux prévisions, soit il existe une opportunité de croissance significative. La validation ne nécessite pas une alignement parfait, mais elle devrait permettre d’expliquer de manière défendable toutes les différences importantes.
Étape 8 : Documenter les hypothèses et créer des modèles de scénarios. La transparence quant à la méthodologie renforce la crédibilité auprès des parties prenantes et permet de mener des discussions productives sur le potentiel du marché. Document qui décrit les sources de données utilisées pour la synthèse, les critères de qualification qui définissent chaque niveau de marché, les hypothèses qui expliquent les taux d’adoption, et les éléments qui viennent compléter les données grâce à l’expertise des experts. Établissez des scénarios alternatifs en testant différentes hypothèses : optimiste (adoption plus élevée, croissance plus rapide), cas de référence (hypothèses modérées) et conservateur (adoption plus lente, concurrence accrue). Le faible coût marginal des données synthétiques rend l’analyse des scénarios pratique, ce qui permet de générer des populations synthétiques supplémentaires reflétant différentes conditions du marché ou les comportements des clients.
Meilleures pratiques pour les données de dimensionnement du marché synthétique
1. Prioriser l’exactitude démographique au détriment de la complexité comportementale lors de la synthèse initiale. Les populations synthétiques doivent correspondre fidèlement aux distributions démographiques connues avant d’appliquer des variables comportementales. Vérifiez que les distributions d’âge, de revenus, de géographie, d’éducation et de profil commercial s’alignent sur les données du recensement ou de l’industrie dans un intervalle de 2 à 3 points de pourcentage. Les variables comportementales (intention d’achat, préférences de marque, volonté de payer) peuvent ensuite être modélisées en fonction de ces bases démographiques, assurant une cohérence interne.
2. Générez plusieurs échantillons synthétiques indépendants pour évaluer la stabilité. Créez trois populations synthétiques distinctes à l’aide de la même méthodologie et des mêmes données de référence. Calculez le TAM/SAM/SOM pour chacun d’entre elles indépendamment. Si les estimations diffèrent de plus de 15 à 20 %, examinez les variables qui expliquent cette variation et les contraintes supplémentaires ou la nécessité d’utiliser un échantillon plus important. Des résultats cohérents entre les échantillons indépendants indiquent une méthodologie robuste ; une grande variabilité indique que votre processus de génération n’a pas suffisamment capturé la structure de la population.
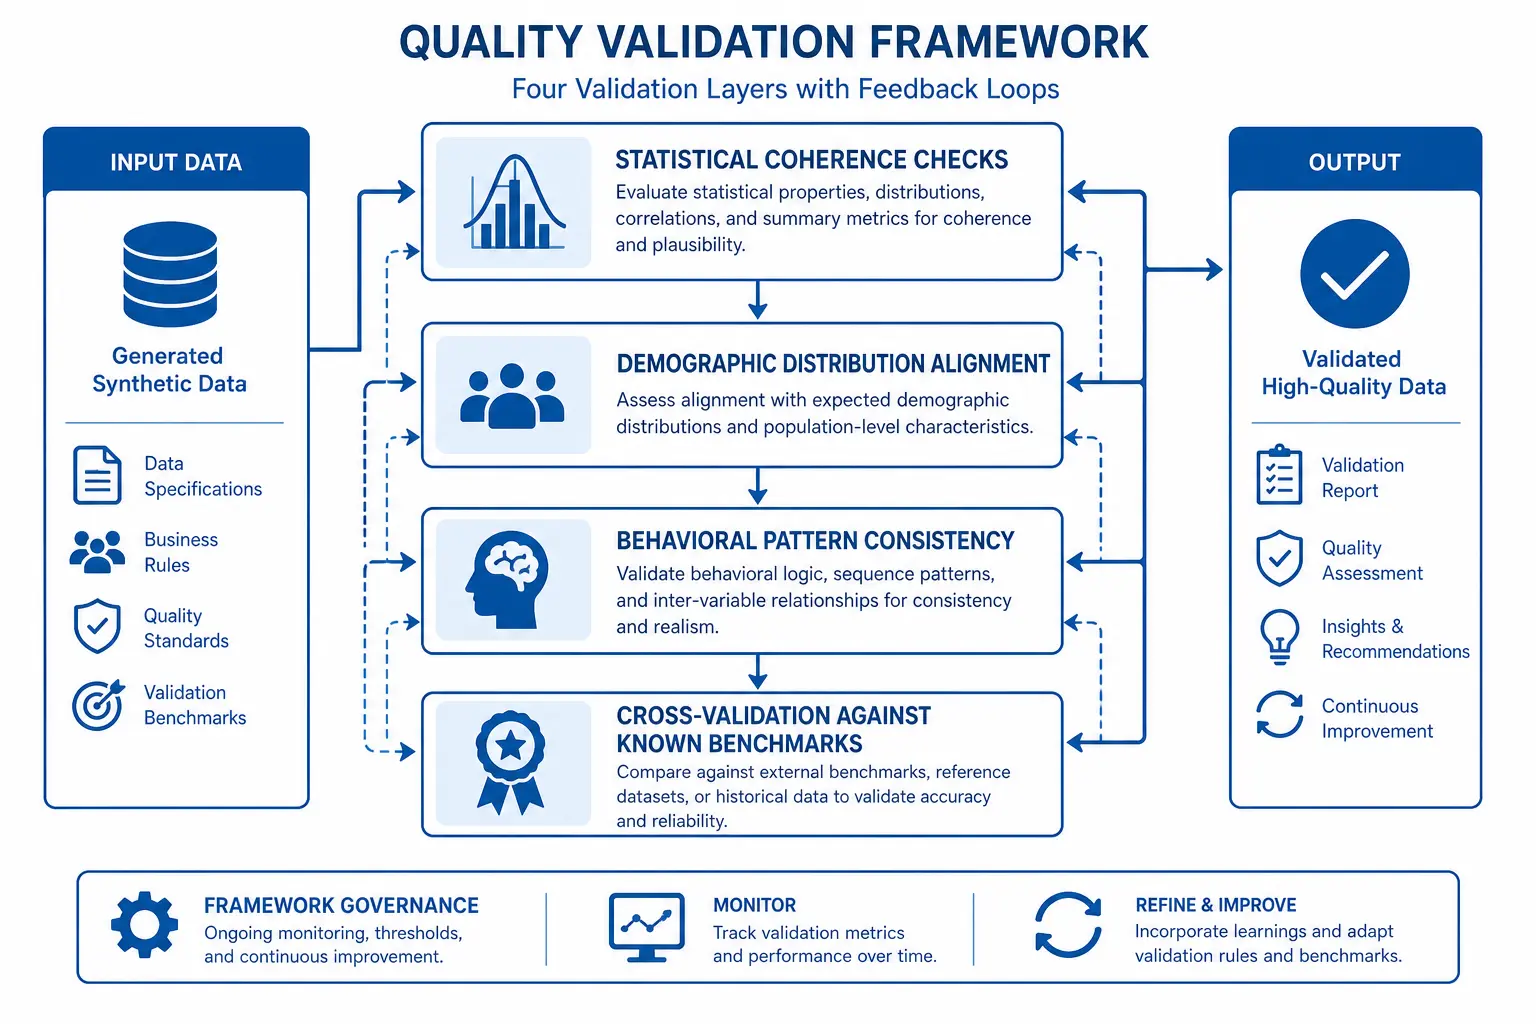
3. Intégrer des points de contrôle de validation dans l’ensemble de la population synthétique. Insérez des tests de vérification des réponses connues dans vos données synthétiques pour vérifier la cohérence logique. Si un répondant synthétique indique être un directeur financier âgé de 28 ans d’une entreprise de 2 000 employés, indiquez que ce profil est improbable. Les dirigeants financiers de cette taille ont généralement plus de 15 ans d’expérience. Élaborez des règles de validation vérifiant les combinaisons impossibles, les incohérences logiques et les écarts statistiques qui ne se verraient jamais dans les populations réelles. Supprimez ou régénérez les enregistrements qui échouent à ces contrôles.
4. Élaborer des données synthétiques pour corriger les biais connus dans les sources de référence. Si vos données de formation sous-estiment certains segments ou les sous-estiment trop, appliquez des coefficients de post-stratification pour aligner la production synthétique sur les paramètres de la population cible. Les panels de consommateurs sous-estiment souvent les ménages à faible revenu et les ménages à très haut revenu ; les données du recensement fournissent la répartition correcte pour le ré-étalonnage. Les bases de données B2B sont plus orientées vers les entreprises plus grandes et plus visibles ; les registres d’entreprise des pouvoirs publics offrent des distributions de taille plus complètes pour le calibrage.
5. Testez la sensibilité des prix grâce à des expériences de choix conjoint ou discret. Au lieu de demander à des répondants synthétiques une seule question concernant leur volonté de payer, modélisez leurs choix à l’échelle de plusieurs configurations de produit, de points de prix et d’alternatives concurrentes. Cette approche produit des courbes de demande et des estimations de revenus plus réalistes car elle prend en compte les décisions de compromis plutôt que les intentions déclarées. Un répondant synthétique qui affirme payer $299 par mois pourrait choisir l’offre de son concurrent à $199 lorsqu’il est présenté avec des comparaisons des caractéristiques réelles.
6. Contrairement à ce que l’on pourrait penser, des échantillons synthétiques plus petits mais plus rigoureux sur le plan de la validation donnent de meilleurs résultats que des échantillons plus volumineux mais moins rigoureux. Une population synthétique de 5 000 enregistrements, validée rigoureusement par rapport à de multiples critères de référence, testée pour sa cohérence logique et pondérée afin de correspondre aux distributions connues, produira une estimation du marché plus fiable que celle d’une population de 50 000 enregistrements générée sans validation. La qualité de la synthèse compte plus que la quantité d’enregistrements. Concentrez vos efforts sur les procédures de validation plutôt que de maximiser simplement la taille de l’échantillon.
7. Document the provenance of every variable in your synthetic dataset. Maintain a data dictionary that traces each field back to its source: census-derived, modeled from customer data, imputed from industry benchmarks, or generated through statistical relationships. This transparency enables stakeholders to assess which estimates rest on strong empirical foundations versus which depend on modeling assumptions. It also facilitates updates when better reference data becomes available.
Comment l’IA transforme les données synthétiques pour la dimensionnement du marché en 2026
Large language models now generate synthetic survey responses that capture nuanced customer reasoning, not just demographic facts and purchase intent scores. When a synthetic respondent indicates they would not purchase a product, LLM-powered systems can generate plausible explanations grounded in that respondent’s demographic profile, current solution usage, and pain points. This qualitative richness enables market sizing teams to understand not just how many potential customers exist but why certain segments show higher or lower propensity to adopt.
Multimodal AI systems integrate diverse data sources demographic databases, social media signals, economic indicators, competitive intelligence into unified synthetic populations with unprecedented realism. Rather than building synthetic datasets from a single reference source, 2026 approaches fuse multiple information streams to create synthetic respondents whose characteristics reflect complex real-world correlations. A synthetic small business owner’s technology adoption patterns correlate appropriately with their industry vertical, company growth trajectory, and regional economic conditions because the AI synthesis process learned these relationships from integrated data.
Continuous learning systems update synthetic populations automatically as new market intelligence arrives. Traditional market sizing becomes outdated the moment fieldwork concludes, but AI-driven synthetic approaches can incorporate new competitor launches, regulatory changes, or economic shifts into refreshed market estimates within hours. Organizations implement dynamic market sizing frameworks where synthetic populations evolve alongside market conditions, providing always-current TAM/SAM/SOM estimates that inform agile strategic planning.
Causal inference AI distinguishes correlation from causation in synthetic data generation, producing more accurate adoption forecasts. Early synthetic data methods simply replicated statistical patterns from training data, but causal AI models understand which variables drive purchase decisions versus which merely correlate with them. This distinction matters enormously for market sizing knowing that product adoption is caused by specific pain points rather than just correlated with certain demographics enables more precise SAM and SOM estimates.
Explainable AI techniques make synthetic market sizing transparent and auditable. Stakeholders can query why a particular TAM estimate emerged, which assumptions most influenced the result, and how sensitive conclusions are to different modeling choices. This transparency builds confidence in synthetic approaches among executives, investors, and board members who previously viewed AI-generated estimates with skepticism. The black box becomes a glass box, with clear line-of-sight from reference data through synthesis methodology to final market sizing outputs.
Outils et ressources pour la dimensionnement du marché synthétique
Gretel.ai provides a synthetic data platform specifically designed for tabular datasets common in market research. The service accepts CSV files containing reference data and generates statistically equivalent synthetic populations while preserving correlations between variables. Particularly valuable for organizations with proprietary customer databases who want to augment limited real data with synthetic extensions for more robust market sizing. Pricing starts at $500/month for research-grade synthetic data generation.
Pour l'essentiel, IA offers enterprise synthetic data generation with strong privacy guarantees and validation reporting. The platform automatically checks synthetic outputs against reference data distributions and flags statistical anomalies that might compromise market sizing accuracy. Built-in differential privacy ensures synthetic data cannot be reverse-engineered to identify real individuals, addressing compliance concerns when reference data includes customer information. Enterprise licenses begin at $2,000/month.
Python’s SDV (Synthetic Data Vault) library provides open-source tools for generating synthetic tabular, relational, and time-series data. Data scientists can implement custom synthesis workflows tailored to specific market sizing requirements, applying advanced techniques like Gaussian copulas or CTGAN (Conditional Tabular GAN) depending on data characteristics. Free and open-source, requiring Python programming expertise but offering maximum flexibility.
Census Bureau’s Public Use Microdata Sample (PUMS) serves as high-quality reference data for US consumer market sizing. These anonymized individual-level census records provide demographic, economic, and housing characteristics for millions of respondents, offering an empirical foundation for synthetic population generation. Access is free through the Census Bureau’s data portal, though processing large PUMS files requires statistical software and data engineering capabilities.
Statista and IBISWorld supply industry-specific market data that calibrates and validates synthetic estimates. While not synthetic data generators themselves, these platforms provide the external benchmarks necessary to verify that synthetic TAM/SAM/SOM calculations align with established market intelligence. Subscriptions range from $1,200-$5,000 annually depending on industry coverage and user access.
Qualtrics’ Conjoint Analysis tools integrated with synthetic respondent generation enable sophisticated price sensitivity and feature trade-off modeling. Organizations can test dozens of product configurations and pricing scenarios against synthetic populations before committing to expensive choice-based conjoint studies with real respondents. Enterprise Qualtrics licenses with advanced analytics modules start around $10,000 annually.
Conclusion
Synthetic data transforms market sizing from a slow, expensive gate check into a rapid, iterative strategic intelligence function. The methodology delivers validated TAM/SAM/SOM estimates in days rather than months, at costs 70-85% lower than traditional primary research, while enabling continuous refinement as market conditions evolve. Organizations that master synthetic approaches gain decisive advantages in market entry timing, investment allocation, and strategic planning accuracy. The step-by-step framework presented here from defining target parameters through validation against external benchmarks provides a proven path to reliable synthetic market sizing. Best practices around demographic accuracy, independent sample generation, and rigorous validation ensure synthetic estimates meet the standards investors and executives demand. AI advancements in 2026 make synthetic populations more realistic, more transparent, and more dynamically responsive to changing market conditions than ever before. Découvrez comment H-in-Q.com peut vous aider your organization implement synthetic data frameworks that accelerate market intelligence while maintaining research rigor. The competitive advantage belongs to teams that size markets faster and more accurately than their rivals synthetic data makes both possible simultaneously.
Questions fréquemment posées
How accurate is synthetic data for TAM SAM SOM calculations?
Synthetic data achieves 85-92% accuracy for market sizing when properly validated against real-world benchmarks and demographic distributions. The accuracy depends on training data quality, generation methodology, and validation rigor applied during the synthesis process.
Can synthetic data replace traditional market research entirely?
Synthetic data works best as a rapid hypothesis-testing tool before committing to expensive primary research. It excels at early-stage sizing, scenario modeling, and identifying which customer segments warrant deeper investigation through traditional methods.
What sample size of synthetic data do I need for reliable market estimates?
Generate minimum 5,000 synthetic respondents for national market sizing, 10,000+ for segmented analysis across multiple demographics. Larger samples reduce variance in tail segments and enable more granular geographic or psychographic breakdowns.
How do I validate synthetic market sizing data?
Cross-reference synthetic outputs against census data, industry reports, and existing customer data. Check for statistical consistency in demographic distributions, logical coherence in behavioral patterns, and alignment with known market benchmarks before finalizing estimates.
What’s the typical cost savings using synthetic data for market sizing?
Organizations report 70-85% cost reduction compared to traditional primary research. A conventional market sizing study costing $50,000-$100,000 can be replaced with synthetic approaches costing $5,000-$15,000 while delivering results in days instead of months.
Which industries benefit most from synthetic market sizing data?
Fast-moving consumer goods, SaaS, fintech, and healthcare see the highest value. Industries with rapid product cycles, frequent market entry decisions, or need for continuous market monitoring gain competitive advantage from synthetic data’s speed and flexibility.